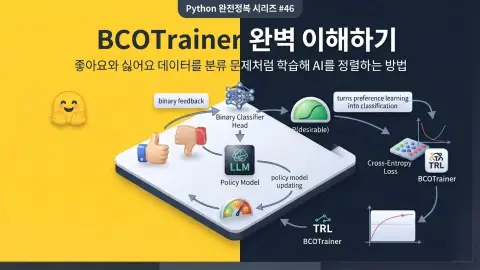
Python 완전정복 시리즈 46: BCOTrainer 완벽 이해하기
Python 완전정복 시리즈 46편입니다. Hugging Face TRL의 BCOTrainer를 이용해 좋아요와 싫어요 같은 Binary Feedback을 분류 문제처럼 활용해 언어 모델을 정렬하는 방법을 정리했습니다. BCO와 KTO·DPO의 차이, Implicit Reward, Reward Shift, UDM, Reference Model, Beta, LoRA·QLoRA, Label Leakage, 실서비스 Feedback Dataset 구축과 실전 학습 코드까지 다룹니다.
BeanCon2026-08-23