목차
메타 설명
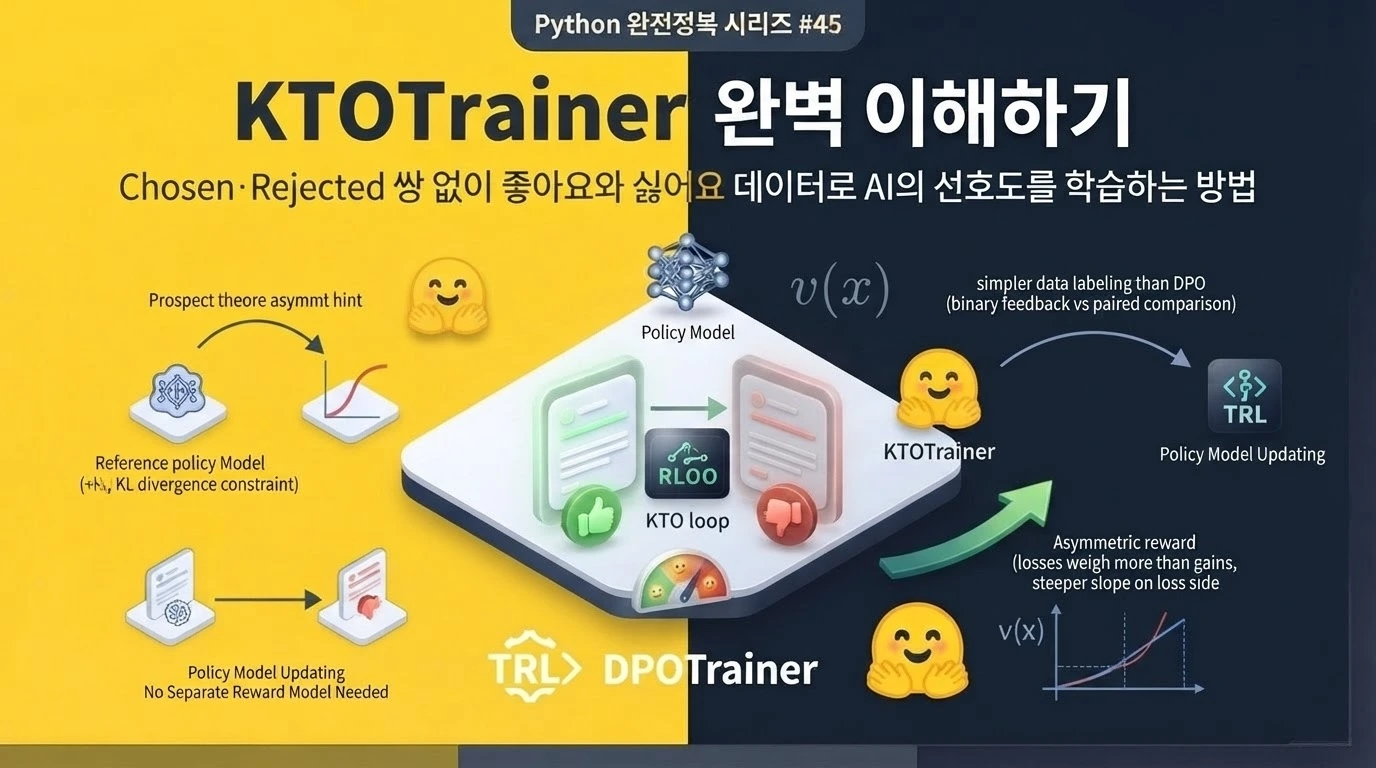
챗봇 서비스에 쌓이는 👍 좋아요와 👎 싫어요 피드백을 AI 학습 데이터로 활용할 수 있을까요? Hugging Face TRL의 KTOTrainer를 이용해 Chosen·Rejected 쌍 없이 Prompt, Completion, Label만으로 언어 모델의 선호도를 조정하는 방법을 알아봅니다. KTO의 개념, DPO와의 차이, Prospect Theory, Reference Model, Beta, 데이터 불균형 처리, LoRA·QLoRA, 실전 학습 코드와 운영 데이터 정제 방법까지 단계별로 정리합니다.
챗봇 서비스를 하나 운영한다고 생각해 보겠습니다.
사용자가 질문합니다.
사용자:

Python에서 리스트 중복 값을
제거하려면 어떻게 하나요?
AI가 답변합니다.
AI:

순서를 유지할 필요가 없다면
set()을 이용할 수 있습니다.

numbers = [1, 2, 2, 3]

unique_numbers = list(set(numbers))
사용자는 답변 아래에 있는 버튼을 누릅니다.
👍다른 사용자는 이런 답변을 받았습니다.
사용자:

None은 어떻게 비교하나요?


AI:

None은 숫자 0과 같으므로
value == 0으로 비교하면 됩니다.
그리고:
👎를 누릅니다.
서비스를 몇 달 운영하니 이런 데이터가 수십만 건 쌓였습니다.
질문 A
답변 A
👍

질문 B
답변 B
👎

질문 C
답변 C
👍

질문 D
답변 D
👍

질문 E
답변 E
👎
이 데이터를 보면서 자연스럽게 이런 생각이 듭니다.
이 좋아요와 싫어요를 그대로 AI 학습에 사용할 수 없을까?
물론 사용할 수 있습니다.
그리고 이 상황에서 상당히 흥미로운 선택지가 바로 KTO입니다.
1. DPO를 쓰려니 데이터가 이상하다
지난 #40에서는 DPOTrainer를 살펴봤습니다.
DPO 데이터는 보통 이렇게 생겼습니다.
하나의 질문

├─ Chosen
│  더 좋은 답변
│
└─ Rejected
   덜 좋은 답변
예를 들면:
{
    "prompt": "Python 변수란 무엇인가요?",
    "chosen": "변수는 값을 저장하기 위해 사용하는 이름입니다.",
    "rejected": "변수는 Python 설치 명령입니다."
}
DPO 입장에서는 아주 좋은 데이터입니다.
같은 질문에 대한 두 답변을 나란히 놓고 비교할 수 있기 때문입니다.
문제는 실제 서비스 데이터가 이렇게 친절하게 쌓이지 않는다는 것입니다.
사용자는 대개:
A 답변과 B 답변 중
어느 쪽이 더 좋습니까?
라는 설문에 답하지 않습니다.
그냥:
👍누르고 떠나거나,
👎누르고 창을 닫습니다.
실서비스 로그는 오히려 다음 형태에 가깝습니다.
Prompt + Response + 좋아요또는:
Prompt + Response + 싫어요KTO가 재미있는 이유가 바로 여기 있습니다.
두 답변을 반드시 한 쌍으로 만들 필요가 없습니다.
현재 TRL의 KTOTrainer는 하나의 Prompt와 Completion에 대해 해당 응답이 바람직한지 여부를 나타내는 Boolean Label을 사용하는 Unpaired Preference Dataset을 기본 데이터 형태로 지원합니다.
prompt

completion

label
이 세 가지면 시작할 수 있습니다.
2. KTO란 무엇인가?
KTO는:
Kahneman-Tversky Optimization의 약자입니다.
이름은 행동경제학으로 유명한 Daniel Kahneman과 Amos Tversky에서 가져왔습니다.
KTO는 인간이 이득과 손실을 완전히 대칭적으로 받아들이지 않는다는 Prospect Theory의 아이디어를 언어 모델 정렬 문제에 연결한 방법입니다.
KTO 논문에서는 이를 Human-Aware Loss, 즉 HALO라는 관점으로 설명하며, 기존 Preference Pair의 확률을 직접 최대화하기보다 모델 Generation의 Utility를 직접 최적화하는 방식을 제안했습니다. 중요한 점은 Pairwise Preference가 없어도 Desirable 또는 Undesirable이라는 Binary Signal만으로 학습할 수 있다는 것입니다.
처음에는 이름 때문에 꽤 어려워 보입니다.
하지만 실무 관점에서는 이렇게 기억하면 충분합니다.
DPO

“A와 B 중
어느 답변이 더 좋아?”


KTO

“이 답변은
좋았어? 싫었어?”
이 차이가 꽤 큽니다.
3. 서비스 화면으로 다시 생각해 보기
우리가 흔히 보는 챗봇 UI에는 이런 버튼이 있습니다.
┌──────────────────────────────┐
│ AI 답변                      │
│                              │
│ Python 리스트는 여러 값을... │
│                              │
│        👍        👎          │
└──────────────────────────────┘
사용자가 👍를 누르면:
label = True👎를 누르면:
label = False라고 생각할 수 있습니다.
데이터는 다음처럼 바뀝니다.
{
    "prompt": "Python 리스트란 무엇인가요?",
    "completion": (
        "리스트는 여러 값을 순서대로 저장하는 "
        "변경 가능한 자료형입니다."
    ),
    "label": True
}
다른 데이터:
{
    "prompt": "Python 리스트란 무엇인가요?",
    "completion": (
        "리스트는 숫자 하나만 저장하는 자료형입니다."
    ),
    "label": False
}
여기서 중요한 점이 있습니다.
이 두 데이터는 반드시 같은 질문일 필요가 없습니다.
예를 들어:
{
    "prompt": "가상환경은 왜 사용하나요?",
    "completion": (
        "프로젝트마다 패키지 버전을 "
        "독립적으로 관리하기 위해 사용합니다."
    ),
    "label": True
}
그리고 전혀 다른 질문:
{
    "prompt": "None은 어떻게 비교하나요?",
    "completion": (
        "None은 숫자 0이므로 == 0으로 비교합니다."
    ),
    "label": False
}
도 같은 Dataset에 들어갈 수 있습니다.
이것이 Unpaired Preference입니다.
4. KTO Dataset의 핵심 구조
현재 TRL이 정의하는 Unpaired Preference Dataset은 하나의 `completion`과 해당 Completion이 선호되는지 여부를 나타내는 `label`을 가집니다.
가장 단순한 형식:
{
    "prompt": "The sky is",
    "completion": " blue.",
    "label": True
}
Python 학습용으로 바꾸면:
{
    "prompt": "Python 함수란 무엇인가요?",
    "completion": (
        "함수는 특정 작업을 묶어 "
        "필요할 때 다시 사용할 수 있게 만든 코드입니다."
    ),
    "label": True
}
싫어요:
{
    "prompt": "Python 함수란 무엇인가요?",
    "completion": (
        "함수는 Python 프로그램을 종료하는 명령입니다."
    ),
    "label": False
}
5. Conversational Format도 사용할 수 있다
최근 Chat Model을 Fine-tuning한다면 문자열보다 역할 기반 구조가 더 자연스럽습니다.
{
    "prompt": [
        {
            "role": "user",
            "content": "Python 함수란 무엇인가요?"
        }
    ],
    "completion": [
        {
            "role": "assistant",
            "content": (
                "함수는 특정 작업을 묶어 "
                "재사용할 수 있게 만든 코드입니다."
            )
        }
    ],
    "label": True
}
현재 KTOTrainer는 Standard Format과 Conversational Format을 모두 지원하고, Conversational Dataset이라면 Chat Template도 자동으로 적용합니다.
실습에서는 이 형식을 사용하겠습니다.
6. DPO 데이터도 KTO에서 사용할 수 있다
여기서 한 가지 재미있는 기능이 있습니다.
이미 다음과 같은 DPO Dataset이 있다고 하겠습니다.
{
    "prompt": "Python 변수란 무엇인가요?",

    "chosen": (
        "변수는 값을 저장하기 위한 이름입니다."
    ),

    "rejected": (
        "변수는 Python 설치 명령입니다."
    )
}
KTOTrainer에 이런 Paired Preference Dataset을 전달할 수도 있습니다.
Trainer가 내부적으로:
Chosen
↓
label=True


Rejected
↓
label=False
형태로 나눠 Unpaired Dataset으로 변환합니다.
즉 기존 DPO 데이터가 있다고 버릴 필요는 없습니다.
7. DPO와 KTO는 언제 다르게 느껴질까?
이 부분은 코드보다 실제 데이터 수집 과정을 생각하면 훨씬 이해하기 쉽습니다.
쇼핑몰에서 두 상품을 항상 비교시키려면 사용자에게 이렇게 물어야 합니다.
상품 A와 상품 B 중
어떤 것이 더 좋습니까?
이런 비교 데이터는 꽤 귀합니다.
반면:
이 상품이 마음에 드셨나요?

👍 👎
는 훨씬 쉽게 얻을 수 있습니다.
LLM도 비슷합니다.
DPO 데이터:
Prompt

Answer A

Answer B

A가 더 좋음
KTO 데이터:
Prompt

Answer A

좋았음
또는:
Prompt

Answer B

별로였음
입니다.
8. KTO가 특히 잘 맞는 데이터
실제 서비스에서는 다음과 같은 데이터가 생길 수 있습니다.
챗봇 👍 / 👎

고객 상담 만족 / 불만족

답변 채택 / 미채택

검색 결과 클릭 / 무시

자동 생성 코드 승인 / 반려

AI 문서 요약 사용 / 재생성

답변 신고 / 정상 사용
다만 이것들을 곧바로:
👍 = 완벽한 답변

👎 = 틀린 답변
으로 해석해서는 안 됩니다.
여기부터가 실제 데이터 작업에서 꽤 중요한 부분입니다.
9. 좋아요 하나가 반드시 “정답”이라는 뜻은 아니다
예를 들어 사용자가 다음 질문을 했습니다.
Python에서 파일을 읽는 방법은?AI:
with open("data.txt") as file:
    print(file.read())
사용자:
👍이것은 비교적 명확합니다.
그런데 이런 상황은 어떨까요?
사용자:

회사 내부 서버 IP 알려줘.
AI가 답변을 거절했습니다.
사용자가 화가 나서:
👎를 눌렀습니다.
이 데이터를 그대로 학습하면 모델은 다음을 배울 수도 있습니다.
보안상 거절하는 답변

→ 사용자가 싫어함

→ 덜 생성해야 함
서비스 만족도와 답변의 안전성이 충돌하는 사례입니다.
따라서 실제 KTO Dataset을 만들 때는 클릭 로그를 그대로 Training Dataset으로 넣는 것보다 피드백의 의미를 먼저 정의하는 작업이 중요합니다.
10. 실서비스 로그라면 먼저 걸러야 할 것들
예를 들어 원본 데이터가 이런 형태라고 하겠습니다.
user_id
conversation_id
prompt
response
feedback
created_at
model_version
바로 학습하지 않습니다.
대략 다음 과정을 거치는 편이 좋습니다.
Raw Feedback Log

        ↓

개인정보 제거

        ↓

중복 제거

        ↓

명백한 오클릭 제거

        ↓

Prompt 품질 검사

        ↓

Response 품질 검사

        ↓

안전 정책 확인

        ↓

Label 변환

        ↓

Train / Validation / Test 분리
제가 이런 종류의 Dataset을 만든다면 특히 다음 세 가지를 먼저 확인합니다.
첫째, 한 사용자의 반복 클릭
한 사람이 동일한 답변에 반복적으로 Feedback을 보낼 수 있다면 데이터가 왜곡될 수 있습니다.
둘째, 모델 장애 때문에 받은 싫어요
예를 들어 Response가 비어 있거나 네트워크 오류가 발생했습니다.
👎가 찍혔다고 해서 이것을 언어 모델의 답변 품질 데이터로 쓰는 것은 애매합니다.
셋째, 제품 기능에 대한 불만
“글자가 너무 작아요.”라는 이유로 싫어요를 눌렀다면 모델 품질과 상관이 없습니다.
KTO는 좋은 학습 알고리즘이지만 Label의 의미까지 대신 정리해 주지는 않습니다.
11. Prospect Theory는 왜 등장했을까?
KTO라는 이름을 이해하려면 아주 조금만 심리학 이야기를 해야 합니다.
사람은 일반적으로 같은 크기의 이익과 손실을 똑같이 받아들이지 않는 경향이 있습니다.
이를 아주 단순화하면:
100원을 얻은 기쁨

vs

100원을 잃은 불쾌함
이 둘의 심리적 크기가 정확히 같지 않을 수 있다는 것입니다.
KTO 논문은 이런 Prospect Theory의 관점을 언어 모델 Alignment Objective에 가져왔습니다. Desirable과 Undesirable Generation을 완전히 똑같은 방식으로 취급하기보다 인간의 Utility 관점을 반영한 목적함수를 사용합니다.
수식을 전부 외울 필요는 없습니다.
실습할 때 중요한 것은 다음입니다.
Desirable

→ 이런 Response는
   상대적으로 더 바람직하다


Undesirable

→ 이런 Response는
   상대적으로 덜 바람직하다
그리고:
Reference Model과 비교하면서 Policy를 조정합니다.
12. KTO에도 Reference Model이 있다
DPO를 공부했다면 익숙한 등장인물입니다.
Policy Model

→ 실제로 학습되는 모델


Reference Model

→ 학습 전 행동의 기준
KTO는 Policy가 Desirable Response와 Undesirable Response의 방향을 학습하면서 Reference Policy에서 얼마나 달라졌는지도 사용합니다.
현재 KTOTrainer에서 `ref_model`을 직접 전달할 수 있으며, `None`이면 학습 시작 전 Policy에 해당하는 초기 상태를 Reference Policy로 자동 사용합니다.
Policy:

“사용자들이 이런 답변을
좋아했군.”


Reference:

“원래 너는 이렇게 답했어.”


KTO:

“좋아지는 건 좋은데
너무 갑자기 사람이 바뀌지는 말자.”
13. Beta는 얼마나 변할지를 조절한다
KTOConfig에는:
beta=0.1이 있습니다.
현재 기본값도 `0.1`입니다. Beta가 높을수록 Reference Model에서의 이탈을 더 강하게 제한합니다.
쉽게 말하면:
beta 낮음

→ 새로운 Feedback을
   비교적 적극적으로 반영


beta 높음

→ 기존 모델의 행동을
   더 보수적으로 유지
Beta는 단독으로 조절하기보다 Learning Rate와 함께 봐야 합니다.
14. KTO에서는 Learning Rate를 함부로 높이지 않는 편이 좋다
이 부분은 실제 실습에서 중요합니다.
현재 TRL 문서는 기본 `beta=0.1`에서 대부분의 모델은 Learning Rate를 대체로 `1e-6` 이하로 유지할 것을 안내하고 있으며, 일반적으로 `5e-7`에서 `5e-6` 범위를 강하게 권장합니다. 작은 Dataset이라고 Learning Rate를 과도하게 높이기보다는 Epoch를 늘리는 쪽을 제안합니다.
그래서 이번 실습은:
learning_rate=1e-6부터 시작하겠습니다.
Fine-tuning에서:
“잘 안 배우네?

Learning Rate 10배!”
는 가끔 해결책이 아니라 사고 신고서가 됩니다.
15. KTO에서 의외로 중요한 Batch Size
KTO를 처음 사용할 때 가장 자주 놓칠 만한 부분입니다.
KTO는 KL Divergence를 추정하기 위해 현재 Prompt와 Batch 안의 다른 Completion을 일부러 엇갈리게 연결한 Sample을 사용합니다.
따라서 Batch에 데이터가 하나밖에 없다면 문제가 생깁니다.
현재 KTO 기본 Loss에서는 실제 `per_device_train_batch_size`가 1보다 커야 하며, TRL 문서는 실제 Step Batch Size를 최소 4 정도로 두고 Effective Batch Size는 16에서 128 사이를 권장합니다. Gradient Accumulation으로 Effective Batch를 크게 만들어도 실제 Step Batch가 지나치게 작으면 KL 추정 품질이 떨어질 수 있습니다.
그래서 이번 예제는:
per_device_train_batch_size=4
gradient_accumulation_steps=4
로 설정합니다.
한 GPU 기준 Effective Batch는:
4 × 4

= 16
입니다.
16. 여기서 “Sequential Sampling”도 중요하다
현재 KTO Loss는 KL 계산을 위한 Mismatched Pair를 Batch 이웃 관계를 이용해 미리 구성합니다.
그래서 기본 KTO Loss를 사용할 때 Training Sample 순서를 무작위로 뒤섞어 버리면 이 관계가 깨질 수 있습니다.
현재 KTOConfig에서는 이런 이유로:
train_sampling_strategy="sequential"이 기본값이며, KL을 추정하는 Loss에서는 Sequential Sampling이 요구됩니다.
평소 Trainer에서:
Dataset은 당연히 Shuffle하는 것 아닌가?라고 생각했다면 KTO에서는 조금 다릅니다.
17. 좋아요가 90%, 싫어요가 10%라면?
실제 서비스에서는 자주 발생합니다.
예:
👍 9,000개

👎 1,000개
그냥 학습하면 Positive Feedback이 Dataset을 압도할 수 있습니다.
KTOConfig에는 이를 위한:
desirable_weight
undesirable_weight
가 있습니다.
기본값:
desirable_weight=1.0
undesirable_weight=1.0
입니다.
예를 들어:
Positive:
300

Negative:
100
이라면 단순한 시작점으로:
desirable_weight=1.0
undesirable_weight=3.0
처럼 Negative Loss의 비중을 높이는 방법을 생각할 수 있습니다.
현재 TRL 문서는 가중치를 적용한 Positive와 Negative의 총량 비율이 대략 `1:1`에서 `4:3` 범위에 들어오도록 덜 흔한 유형을 Upweight하는 방식을 권장합니다.
다만 이것도 무조건적인 공식은 아닙니다.
먼저 왜 Negative가 적은지를 확인하는 것이 먼저입니다.
서비스가 정말 좋아서일 수도 있고,
사용자가 귀찮아서 👎를 잘 누르지 않는 것일 수도 있습니다.
둘은 완전히 다른 데이터입니다.
18. KTO가 DPO보다 무조건 좋은 것은 아니다
이 부분은 꼭 짚고 넘어가야 합니다.
KTO:
Pair가 없어도 됨이라는 장점이 있습니다.
하지만 DPO 데이터가 충분히 잘 구축되어 있다면 Pairwise Comparison 자체가 제공하는 정보가 매우 유용합니다.
예를 들어:
Answer A:
👍

Answer B:
👍
두 답변이 모두 좋은 평가를 받았습니다.
하지만 실제로는:
A:

괜찮은 답변


B:

훨씬 뛰어난 답변
일 수도 있습니다.
Binary Label만 보면 둘은 똑같습니다.
True
True
반면 DPO 데이터라면:
B > A라는 정보를 줄 수 있습니다.
그래서 선택 기준은 이렇게 보는 편이 현실적입니다.
Pairwise Preference가 잘 만들어져 있다
DPO를 적극 검토👍 / 👎 같은 Pointwise Feedback이 많이 쌓여 있다
KTO가 매력적답변 품질을 직접 숫자로 평가하고 싶다
Reward Model현재 Policy가 직접 생성하면서 학습해야 한다
GRPO / RLOO / PPO 계열알고리즘보다 보유한 데이터 모양을 먼저 보는 것이 좋습니다.
19. 현재 KTOTrainer의 상태
2026년 8월 19일 기준 PyPI의 최신 TRL 안정 버전은 1.10.0이며 2026년 8월 13일 공개되었습니다. Python 3.10 이상을 요구합니다.
KTOTrainer는 TRL 1.8.0에서 Experimental 영역을 졸업해 현재는 Top-level Stable API로 사용할 수 있습니다.
따라서 현재 Import 방식은:
from trl import KTOConfig, KTOTrainer입니다.
예전 자료에서:
from trl.experimental.kto import (
    KTOConfig,
    KTOTrainer
)
를 발견할 수 있지만 현재는 Top-level Import를 사용하는 편이 좋습니다. Experimental 경로는 향후 제거될 예정입니다.
20. 환경 설치
가상환경부터 만들어 보겠습니다.
Windows
python -m venv venv
venv\Scripts\activate
macOS · Linux
python3 -m venv venv
source venv/bin/activate
패키지 설치:
python -m pip install --upgrade pip
python -m pip install "transformers[torch]" datasets accelerate peft trl
버전 확인:
import torch
import transformers
import trl
import peft


print("TRL:", trl.__version__)
print("Transformers:", transformers.__version__)
print("PEFT:", peft.__version__)
print("PyTorch:", torch.__version__)
print("CUDA:", torch.cuda.is_available())
21. 실습 모델
이번에도 학습 흐름을 확인하기 위해 비교적 작은 모델을 사용하겠습니다.
MODEL_ID = "Qwen/Qwen2.5-0.5B-Instruct"공식 KTO 문서의 Quick Start도 Qwen 계열 0.5B 모델과 KTO Mix Dataset을 사용합니다.
실습의 목적은 거대한 모델을 만드는 것이 아닙니다.
KTO Dataset 구성

↓

LoRA 연결

↓

KTOTrainer 실행

↓

학습 로그 확인

↓

Adapter 저장

↓

학습 전후 답변 비교
전체 흐름을 손으로 한 번 지나가 보는 것이 목표입니다.
22. 우리만의 Python 교관 Feedback Dataset 만들기
이번에는 이전 글의 Chosen·Rejected 예제를 재활용하지 않고, 실제 챗봇 서비스에서 Feedback이 들어온 상황을 가정해 데이터를 만들겠습니다.
System Message:
SYSTEM_MESSAGE = (
    "당신은 Python을 처음 배우는 사람에게 "
    "개념을 정확하고 자연스럽게 설명하는 튜터입니다. "
    "불필요하게 장황하게 말하지 않고 "
    "필요할 때 짧은 예제를 제공합니다."
)
좋아요 데이터:
{
    "prompt": [
        {
            "role": "system",
            "content": SYSTEM_MESSAGE
        },
        {
            "role": "user",
            "content": "Python 변수는 왜 필요한가요?"
        }
    ],

    "completion": [
        {
            "role": "assistant",
            "content": (
                "변수는 값을 나중에 다시 사용하기 위해 "
                "이름을 붙여 두는 방법입니다.\n\n"
                "예를 들어 age = 20이라고 작성하면 "
                "이후에는 숫자 20 대신 age라는 이름으로 "
                "그 값을 사용할 수 있습니다."
            )
        }
    ],

    "label": True
}
싫어요 데이터:
{
    "prompt": [
        {
            "role": "system",
            "content": SYSTEM_MESSAGE
        },
        {
            "role": "user",
            "content": "None은 언제 사용하나요?"
        }
    ],

    "completion": [
        {
            "role": "assistant",
            "content": (
                "None은 숫자 0과 같은 값이므로 "
                "둘을 구분할 필요가 없습니다."
            )
        }
    ],

    "label": False
}
이것이 KTO Dataset의 기본입니다.
23. label은 반드시 Boolean으로 관리하는 편이 좋다
서비스 로그에는 다음처럼 저장되어 있을 수 있습니다.
UP

DOWN
또는:
1

-1
또는:
LIKE

DISLIKE
학습 Dataset으로 변환할 때는 명확하게:
True
False
로 바꾸는 편이 좋습니다.
예:
def convert_feedback(
    feedback: str
) -> bool:
    if feedback == "LIKE":
        return True

    if feedback == "DISLIKE":
        return False

    raise ValueError(
        f"알 수 없는 feedback: {feedback}"
    )
애매한 Feedback은 억지로 Label을 만들지 않는 것이 낫습니다.
SKIP

REPORT

REGENERATE

COPY

SHARE
등은 각각 다른 의미일 수 있습니다.
24. 실제 로그를 KTO Dataset으로 바꾸는 예
원본:
raw_logs = [
    {
        "question": "Python 리스트란?",
        "answer": (
            "리스트는 여러 값을 순서대로 "
            "저장하는 자료형입니다."
        ),
        "feedback": "LIKE"
    },
    {
        "question": "튜플은 수정 가능한가요?",
        "answer": (
            "네. 튜플은 리스트처럼 "
            "언제든 수정할 수 있습니다."
        ),
        "feedback": "DISLIKE"
    }
]
변환:
def convert_log(
    row: dict
) -> dict:
    return {
        "prompt": [
            {
                "role": "system",
                "content": SYSTEM_MESSAGE
            },
            {
                "role": "user",
                "content": row["question"]
            }
        ],

        "completion": [
            {
                "role": "assistant",
                "content": row["answer"]
            }
        ],

        "label": (
            row["feedback"] == "LIKE"
        )
    }
Dataset:
from datasets import Dataset


dataset = Dataset.from_list(
    [
        convert_log(row)
        for row in raw_logs
    ]
)
25. 데이터 중복을 먼저 제거하자
실서비스에서는 같은 질문과 답변이 여러 번 들어올 수 있습니다.
간단한 Key를 만들 수 있습니다.
def make_key(
    question: str,
    answer: str
) -> tuple[str, str]:
    return (
        question.strip(),
        answer.strip()
    )
중복 제거:
def deduplicate_logs(
    rows: list[dict]
) -> list[dict]:
    seen = set()
    result = []

    for row in rows:
        key = make_key(
            row["question"],
            row["answer"]
        )

        if key in seen:
            continue

        seen.add(key)
        result.append(row)

    return result
다만 동일 답변에 여러 사용자가 Feedback을 준 경우라면 단순 중복 삭제보다 투표를 집계하는 방식이 더 적절할 수 있습니다.
예:
같은 답변

👍 92

👎 8
이면 Positive로 볼 근거가 비교적 강합니다.
반대로:
👍 51

👎 49
이면 애매한 Sample입니다.
이런 데이터를 억지로 Positive로 만드는 것보다 제외하는 편이 나을 수 있습니다.
26. 애매한 Feedback을 제거하는 간단한 기준
예:
def decide_label(
    likes: int,
    dislikes: int,
    min_votes: int = 3,
    confidence: float = 0.7
) -> bool | None:
    total = likes + dislikes

    if total < min_votes:
        return None

    like_ratio = likes / total

    if like_ratio >= confidence:
        return True

    if like_ratio <= 1 - confidence:
        return False

    return None
사용:
label = decide_label(
    likes=18,
    dislikes=2
)

print(label)
결과:
True반면:
label = decide_label(
    likes=11,
    dislikes=9
)
결과:
None이런 Sample은 학습에서 제외할 수 있습니다.
알고리즘을 바꾸는 것보다 애매한 데이터를 버리는 것이 더 큰 개선이 되는 경우도 많습니다.
27. Train과 Validation을 Label 비율에 맞게 나누기
작은 Dataset에서 무작위로 나누다 보면:
Train:

👍 👍 👍 👎 👍


Validation:

👍 👍 👍 👍
처럼 Validation에 Negative Sample이 하나도 없는 상황이 생길 수 있습니다.
간단한 Stratified Split 함수를 만들어 보겠습니다.
import random

from datasets import Dataset


def stratified_split(
    examples: list[dict],
    test_ratio: float = 0.2,
    seed: int = 2026
):
    rng = random.Random(seed)

    positives = [
        row
        for row in examples
        if row["label"] is True
    ]

    negatives = [
        row
        for row in examples
        if row["label"] is False
    ]

    rng.shuffle(positives)
    rng.shuffle(negatives)

    positive_test_size = max(
        1,
        int(
            len(positives)
            * test_ratio
        )
    )

    negative_test_size = max(
        1,
        int(
            len(negatives)
            * test_ratio
        )
    )

    test_rows = (
        positives[:positive_test_size]
        + negatives[:negative_test_size]
    )

    train_rows = (
        positives[positive_test_size:]
        + negatives[negative_test_size:]
    )

    rng.shuffle(train_rows)
    rng.shuffle(test_rows)

    return (
        Dataset.from_list(train_rows),
        Dataset.from_list(test_rows)
    )
28. Label 분포를 눈으로 확인하자
학습 전에 이것만은 출력해 보는 것을 권합니다.
def print_label_stats(
    name: str,
    dataset
):
    labels = dataset["label"]

    positives = sum(
        bool(label)
        for label in labels
    )

    negatives = (
        len(labels)
        - positives
    )

    print(
        f"[{name}]"
    )

    print(
        f"전체: {len(labels)}"
    )

    print(
        f"좋아요: {positives}"
    )

    print(
        f"싫어요: {negatives}"
    )
실행:
print_label_stats(
    "TRAIN",
    train_dataset
)

print_label_stats(
    "VALIDATION",
    validation_dataset
)
머신러닝 프로젝트에서 DataFrame 한 줄 보는 시간을 아끼다가 GPU 몇 시간을 날리는 일이 생각보다 흔합니다.
29. KTOConfig 살펴보기
기본적인 설정을 만들어 보겠습니다.
from trl import KTOConfig


training_args = KTOConfig(
    output_dir=(
        "outputs/"
        "python-tutor-kto"
    ),

    learning_rate=1e-6,

    per_device_train_batch_size=4,
    per_device_eval_batch_size=4,

    gradient_accumulation_steps=4,

    num_train_epochs=3,

    beta=0.1,

    desirable_weight=1.0,
    undesirable_weight=1.0,

    max_length=512,

    eval_strategy="epoch",
    save_strategy="epoch",

    logging_steps=5,

    load_best_model_at_end=True,

    metric_for_best_model=(
        "eval_loss"
    ),

    greater_is_better=False,

    save_total_limit=2,

    report_to="none",

    seed=2026,
    data_seed=2026
)
현재 KTOConfig의 기본값에는 `learning_rate=1e-6`, `max_length=1024`, `loss_type="kto"`, `beta=0.1`, `desirable_weight=1.0`, `undesirable_weight=1.0`이 포함됩니다. Gradient Checkpointing도 기본적으로 활성화되어 있습니다.
30. max_length는 무조건 크게 잡는 것이 답이 아니다
KTOTrainer는:
Prompt

+

Completion
전체를 Tokenize합니다.
현재 기본 최대 길이는:
max_length=1024입니다. 이를 넘어가는 Sequence는 오른쪽에서 Truncation됩니다.
짧은 QA Dataset이라면:
max_length=512정도로 시작할 수 있습니다.
중요한 것은 Dataset의 실제 길이를 확인하는 것입니다.
31. LoRA로 KTO 학습하기
전체 모델을 Fine-tuning하지 않고 Adapter만 학습해 보겠습니다.
from peft import (
    LoraConfig,
    TaskType
)


lora_config = LoraConfig(
    task_type=(
        TaskType.CAUSAL_LM
    ),

    inference_mode=False,

    r=16,

    lora_alpha=32,

    lora_dropout=0.05,

    target_modules=[
        "q_proj",
        "k_proj",
        "v_proj",
        "o_proj"
    ],

    bias="none"
)
현재 KTOTrainer는 PEFT를 직접 지원하며 `peft_config`를 전달해 Adapter만 학습할 수 있습니다.
32. KTOTrainer 생성
Tokenizer:
from transformers import (
    AutoTokenizer
)


tokenizer = (
    AutoTokenizer
    .from_pretrained(
        MODEL_ID
    )
)


if tokenizer.pad_token is None:
    tokenizer.pad_token = (
        tokenizer.eos_token
    )
Trainer:
from trl import KTOTrainer


trainer = KTOTrainer(
    model=MODEL_ID,

    args=training_args,

    train_dataset=train_dataset,

    eval_dataset=validation_dataset,

    processing_class=tokenizer,

    peft_config=lora_config
)
현재 Trainer는 모델 ID, Causal LM 객체 또는 PEFT Model 객체를 받을 수 있으며, `processing_class`, `quantization_config`, `peft_config`도 지원합니다.
학습:
trainer.train()이렇게 보면 생각보다 단순합니다.
어려운 부분은 Trainer를 호출하는 코드보다 Training Dataset을 믿을 수 있게 만드는 과정입니다.
33. 학습 로그에서는 무엇을 봐야 할까?
현재 KTOTrainer는 다음과 같은 지표를 기록합니다.
loss

entropy

kl

logits/chosen

logits/rejected

logps/chosen

logps/rejected

rewards/chosen

rewards/rejected

rewards/margins
여기서 `chosen`과 `rejected`라는 이름이 조금 헷갈릴 수 있습니다.
KTO Dataset에는 Pair가 없지만 Metric에서는:
chosen

→ desirable


rejected

→ undesirable
의 의미로 사용됩니다.
34. rewards/margins를 눈여겨보자
rewards/margins는 Desirable과 Undesirable Completion 사이의 Implicit Reward 차이를 나타냅니다. 공식 Quick Start에서도 Reward Margin의 증가 추세를 학습 진행을 확인하는 방법 중 하나로 소개합니다.
이상적인 방향을 단순하게 표현하면:
좋아요 Response

Reward ↑


싫어요 Response

Reward ↓
입니다.
다만 Training Margin 하나만 높다고 실제 서비스 품질이 좋아졌다고 판단하면 안 됩니다.
별도 Test Prompt와 사람 평가가 필요합니다.
35. Reference Log Probability를 미리 계산할 수도 있다
KTO는 Reference Model의 Log Probability가 필요합니다.
매 Training Step마다 Reference Forward를 수행하는 대신:
precompute_ref_log_probs=True를 사용하면 전체 Dataset의 Reference Log Probability를 학습 전에 미리 계산할 수 있습니다.
현재 공식 문서는 이 방식이 학습 중 Reference Model을 계속 메모리에 유지할 필요를 줄여 메모리를 절약할 수 있다고 설명합니다.
예:
training_args = KTOConfig(
    output_dir="outputs/kto",

    precompute_ref_log_probs=True,

    precompute_ref_batch_size=8
)
다만 현재 다음 구성과는 제약이 있습니다.
IterableDataset

Vision Dataset

일부 Liger 설정

sync_ref_model
등입니다.
처음 실습에서는 기본값인 `False`로 두겠습니다.
36. KTO 외에 apo_zero_unpaired도 있다
현재 KTOConfig의 `loss_type`은 두 가지를 제공합니다.
loss_type="kto"그리고:
loss_type="apo_zero_unpaired"입니다.
기본값은:
loss_type="kto"입니다.
`apo_zero_unpaired`는 KL Divergence를 추정하지 않고 Desirable Completion의 가능성을 높이고 Undesirable Completion의 가능성을 낮추는 Unpaired APO-zero 변형입니다.
처음에는 기본 KTO부터 사용하는 편이 이해하기 쉽습니다.
37. KTO에서 QLoRA도 사용할 수 있다
TRL 1.10 계열에서는 KTOTrainer에 `quantization_config`를 직접 전달할 수 있습니다. 이 기능은 Model ID 문자열에서 모델을 로드할 때 적용됩니다.
예:
import torch

from transformers import (
    BitsAndBytesConfig
)


compute_dtype = (
    torch.bfloat16
    if (
        torch.cuda.is_available()
        and torch.cuda.is_bf16_supported()
    )
    else torch.float16
)


quantization_config = (
    BitsAndBytesConfig(
        load_in_4bit=True,

        bnb_4bit_quant_type="nf4",

        bnb_4bit_use_double_quant=True,

        bnb_4bit_compute_dtype=(
            compute_dtype
        )
    )
)
Trainer:
trainer = KTOTrainer(
    model=MODEL_ID,

    args=training_args,

    train_dataset=train_dataset,

    processing_class=tokenizer,

    peft_config=lora_config,

    quantization_config=(
        quantization_config
    )
)
이미 Model Object를 직접 만들어 Trainer에 넘겼다면 Trainer 쪽 `quantization_config`를 다시 적용할 수 없습니다. 현재 구현은 이 경우 명시적인 오류를 발생시킵니다.
38. 실전 프로젝트: 좋아요와 싫어요로 Python 튜터 학습하기
이제 전체 코드를 하나로 묶어보겠습니다.
아래 예제는 실제 서비스 규모의 모델을 만드는 코드가 아니라 KTO 데이터 구조와 학습 흐름을 확인하기 위한 실습용 프로젝트입니다.
`train_kto.py`로 저장합니다.
from pathlib import Path
import random

import torch

from datasets import Dataset

from peft import (
    LoraConfig,
    TaskType
)

from transformers import (
    AutoTokenizer,
    set_seed
)

from trl import (
    KTOConfig,
    KTOTrainer
)


MODEL_ID = (
    "Qwen/"
    "Qwen2.5-0.5B-Instruct"
)

OUTPUT_DIR = Path(
    "outputs/"
    "python-tutor-kto"
)

ADAPTER_DIR = Path(
    "models/"
    "python-tutor-kto-lora"
)

SEED = 2026


SYSTEM_MESSAGE = (
    "당신은 Python을 처음 배우는 사람에게 "
    "개념을 정확하고 자연스럽게 설명하는 튜터입니다. "
    "핵심을 먼저 설명하고 필요한 경우 "
    "짧은 코드 예제를 제공합니다."
)


RAW_FEEDBACK = [
    {
        "question": (
            "Python 변수는 왜 필요한가요?"
        ),
        "answer": (
            "변수는 값을 나중에 다시 사용하기 위해 "
            "이름을 붙여 두는 방법입니다. "
            "예를 들어 age = 20이라고 작성하면 "
            "이후에는 age라는 이름으로 값을 사용할 수 있습니다."
        ),
        "label": True
    },
    {
        "question": (
            "Python 변수는 왜 필요한가요?"
        ),
        "answer": (
            "변수는 Python을 설치하는 명령입니다."
        ),
        "label": False
    },
    {
        "question": (
            "리스트와 튜플의 차이는 무엇인가요?"
        ),
        "answer": (
            "리스트는 생성 후 값을 추가하거나 수정할 수 있지만 "
            "튜플은 일반적으로 생성 후 값을 변경할 수 없습니다."
        ),
        "label": True
    },
    {
        "question": (
            "리스트와 튜플의 차이는 무엇인가요?"
        ),
        "answer": (
            "리스트와 튜플은 이름만 다르고 "
            "사용 방법은 완전히 같습니다."
        ),
        "label": False
    },
    {
        "question": (
            "for 반복문은 언제 사용하나요?"
        ),
        "answer": (
            "여러 데이터를 하나씩 꺼내 같은 작업을 반복할 때 "
            "for 문을 사용하면 편리합니다."
        ),
        "label": True
    },
    {
        "question": (
            "for 반복문은 언제 사용하나요?"
        ),
        "answer": (
            "for 문은 프로그램을 강제로 종료할 때 사용합니다."
        ),
        "label": False
    },
    {
        "question": (
            "while 문에서 주의할 점은 무엇인가요?"
        ),
        "answer": (
            "조건이 언젠가 False가 되도록 반복 중에 "
            "관련 상태가 바뀌어야 합니다. "
            "그렇지 않으면 무한 반복이 발생할 수 있습니다."
        ),
        "label": True
    },
    {
        "question": (
            "while 문에서 주의할 점은 무엇인가요?"
        ),
        "answer": (
            "while 문은 시작하면 항상 무한 반복되므로 "
            "실제 프로그램에서는 사용할 수 없습니다."
        ),
        "label": False
    },
    {
        "question": (
            "함수에서 return은 무슨 역할을 하나요?"
        ),
        "answer": (
            "return은 함수가 만든 결과를 호출한 곳으로 전달하고 "
            "함수 실행을 종료합니다."
        ),
        "label": True
    },
    {
        "question": (
            "함수에서 return은 무슨 역할을 하나요?"
        ),
        "answer": (
            "return은 print와 같은 명령이라 "
            "항상 화면에 값을 출력합니다."
        ),
        "label": False
    },
    {
        "question": (
            "딕셔너리는 언제 사용하나요?"
        ),
        "answer": (
            "Key와 Value 형태로 데이터를 연결해 저장하고 싶을 때 "
            "딕셔너리가 유용합니다."
        ),
        "label": True
    },
    {
        "question": (
            "딕셔너리는 언제 사용하나요?"
        ),
        "answer": (
            "딕셔너리는 영어 단어를 한국어로 번역하는 "
            "Python 전용 프로그램입니다."
        ),
        "label": False
    },
    {
        "question": (
            "None은 어떻게 비교하는 것이 좋나요?"
        ),
        "answer": (
            "None을 확인할 때는 일반적으로 "
            "is None 또는 is not None을 사용합니다."
        ),
        "label": True
    },
    {
        "question": (
            "None은 어떻게 비교하는 것이 좋나요?"
        ),
        "answer": (
            "None은 숫자 0과 같기 때문에 "
            "항상 value == 0으로 검사하면 됩니다."
        ),
        "label": False
    },
    {
        "question": (
            "가상환경을 사용하는 이유가 무엇인가요?"
        ),
        "answer": (
            "프로젝트마다 필요한 패키지와 버전을 "
            "독립적으로 관리해 충돌을 줄이기 위해 사용합니다."
        ),
        "label": True
    },
    {
        "question": (
            "가상환경을 사용하는 이유가 무엇인가요?"
        ),
        "answer": (
            "가상환경을 만들면 Python 프로그램의 실행 속도가 "
            "항상 두 배 빨라집니다."
        ),
        "label": False
    },
    {
        "question": (
            "파일을 열 때 with 문을 사용하는 이유는 무엇인가요?"
        ),
        "answer": (
            "with 문을 사용하면 파일 작업이 끝난 뒤 "
            "파일을 자동으로 정리하고 닫을 수 있습니다."
        ),
        "label": True
    },
    {
        "question": (
            "파일을 열 때 with 문을 사용하는 이유는 무엇인가요?"
        ),
        "answer": (
            "with 문을 사용하면 파일 내용이 자동으로 "
            "인터넷에 백업됩니다."
        ),
        "label": False
    },
    {
        "question": (
            "set 자료형의 특징을 알려주세요."
        ),
        "answer": (
            "set은 중복되지 않는 값들을 저장하는 집합 자료형으로 "
            "중복 제거나 집합 연산에 유용합니다."
        ),
        "label": True
    },
    {
        "question": (
            "set 자료형의 특징을 알려주세요."
        ),
        "answer": (
            "set은 리스트와 완전히 같으며 "
            "모든 중복 값을 그대로 보관합니다."
        ),
        "label": False
    },
    {
        "question": (
            "enumerate는 언제 사용하나요?"
        ),
        "answer": (
            "반복하면서 값과 인덱스를 함께 사용하고 싶을 때 "
            "enumerate를 사용하면 편리합니다."
        ),
        "label": True
    },
    {
        "question": (
            "enumerate는 언제 사용하나요?"
        ),
        "answer": (
            "enumerate는 리스트의 모든 데이터를 "
            "삭제하는 함수입니다."
        ),
        "label": False
    },
    {
        "question": (
            "Boolean 자료형은 무엇인가요?"
        ),
        "answer": (
            "Boolean은 참과 거짓을 표현하며 "
            "Python에서는 True와 False를 사용합니다."
        ),
        "label": True
    },
    {
        "question": (
            "Boolean 자료형은 무엇인가요?"
        ),
        "answer": (
            "Boolean은 문자열만 저장할 수 있는 자료형입니다."
        ),
        "label": False
    }
]


def to_kto_example(
    row: dict
) -> dict:
    return {
        "prompt": [
            {
                "role": "system",
                "content": SYSTEM_MESSAGE
            },
            {
                "role": "user",
                "content": row["question"]
            }
        ],

        "completion": [
            {
                "role": "assistant",
                "content": row["answer"]
            }
        ],

        "label": bool(
            row["label"]
        )
    }


def stratified_split(
    examples: list[dict],
    test_ratio: float = 0.25
):
    rng = random.Random(
        SEED
    )

    positives = [
        row
        for row in examples
        if row["label"] is True
    ]

    negatives = [
        row
        for row in examples
        if row["label"] is False
    ]

    rng.shuffle(
        positives
    )

    rng.shuffle(
        negatives
    )

    positive_test_size = max(
        1,
        round(
            len(positives)
            * test_ratio
        )
    )

    negative_test_size = max(
        1,
        round(
            len(negatives)
            * test_ratio
        )
    )

    validation_rows = (
        positives[:positive_test_size]
        + negatives[:negative_test_size]
    )

    train_rows = (
        positives[positive_test_size:]
        + negatives[negative_test_size:]
    )

    rng.shuffle(
        train_rows
    )

    rng.shuffle(
        validation_rows
    )

    return (
        Dataset.from_list(
            train_rows
        ),
        Dataset.from_list(
            validation_rows
        )
    )


def print_stats(
    name: str,
    dataset
):
    labels = dataset[
        "label"
    ]

    positive = sum(
        bool(label)
        for label in labels
    )

    negative = (
        len(labels)
        - positive
    )

    print(
        f"\n[{name}]"
    )

    print(
        f"전체: {len(labels)}"
    )

    print(
        f"좋아요: {positive}"
    )

    print(
        f"싫어요: {negative}"
    )


def select_precision():
    if not torch.cuda.is_available():
        return (
            False,
            False,
            torch.float32
        )

    if torch.cuda.is_bf16_supported():
        return (
            True,
            False,
            torch.bfloat16
        )

    return (
        False,
        True,
        torch.float16
    )


def main():
    set_seed(
        SEED
    )

    OUTPUT_DIR.mkdir(
        parents=True,
        exist_ok=True
    )

    ADAPTER_DIR.mkdir(
        parents=True,
        exist_ok=True
    )

    print(
        "[1] KTO Dataset 변환"
    )

    examples = [
        to_kto_example(row)
        for row in RAW_FEEDBACK
    ]

    (
        train_dataset,
        validation_dataset
    ) = stratified_split(
        examples
    )

    print_stats(
        "TRAIN",
        train_dataset
    )

    print_stats(
        "VALIDATION",
        validation_dataset
    )

    print(
        "\n[2] Tokenizer 로딩"
    )

    tokenizer = (
        AutoTokenizer
        .from_pretrained(
            MODEL_ID
        )
    )

    if tokenizer.pad_token is None:
        tokenizer.pad_token = (
            tokenizer.eos_token
        )

    print(
        "[3] LoRA 설정"
    )

    lora_config = (
        LoraConfig(
            task_type=(
                TaskType.CAUSAL_LM
            ),

            inference_mode=False,

            r=16,

            lora_alpha=32,

            lora_dropout=0.05,

            target_modules=[
                "q_proj",
                "k_proj",
                "v_proj",
                "o_proj"
            ],

            bias="none"
        )
    )

    (
        use_bf16,
        use_fp16,
        model_dtype
    ) = select_precision()

    print(
        "[4] KTOConfig 생성"
    )

    training_args = (
        KTOConfig(
            output_dir=str(
                OUTPUT_DIR
            ),

            model_init_kwargs={
                "dtype": model_dtype
            },

            learning_rate=1e-6,

            lr_scheduler_type=(
                "linear"
            ),

            warmup_ratio=0.1,

            per_device_train_batch_size=4,

            per_device_eval_batch_size=4,

            gradient_accumulation_steps=4,

            num_train_epochs=3,

            loss_type="kto",

            beta=0.1,

            desirable_weight=1.0,

            undesirable_weight=1.0,

            max_length=512,

            precompute_ref_log_probs=False,

            eval_strategy="epoch",

            save_strategy="epoch",

            logging_strategy="steps",

            logging_steps=1,

            logging_first_step=True,

            load_best_model_at_end=True,

            metric_for_best_model=(
                "eval_loss"
            ),

            greater_is_better=False,

            save_total_limit=2,

            gradient_checkpointing=True,

            bf16=use_bf16,

            fp16=use_fp16,

            report_to="none",

            seed=SEED,

            data_seed=SEED,

            run_name=(
                "python-tutor-kto"
            )
        )
    )

    print(
        "[5] KTOTrainer 생성"
    )

    trainer = KTOTrainer(
        model=MODEL_ID,

        args=training_args,

        train_dataset=(
            train_dataset
        ),

        eval_dataset=(
            validation_dataset
        ),

        processing_class=(
            tokenizer
        ),

        peft_config=(
            lora_config
        )
    )

    print(
        "\n[학습 가능한 파라미터]"
    )

    trainer.model.print_trainable_parameters()

    print(
        "\n[6] KTO 학습 시작"
    )

    train_result = (
        trainer.train()
    )

    trainer.log_metrics(
        "train",
        train_result.metrics
    )

    trainer.save_metrics(
        "train",
        train_result.metrics
    )

    trainer.save_state()

    print(
        "\n[7] Validation 평가"
    )

    validation_metrics = (
        trainer.evaluate()
    )

    trainer.log_metrics(
        "validation",
        validation_metrics
    )

    trainer.save_metrics(
        "validation",
        validation_metrics
    )

    print(
        "\n[8] Adapter 저장"
    )

    trainer.save_model(
        str(
            ADAPTER_DIR
        )
    )

    tokenizer.save_pretrained(
        ADAPTER_DIR
    )

    print(
        "학습 완료"
    )

    print(
        f"Adapter: "
        f"{ADAPTER_DIR.resolve()}"
    )


if __name__ == "__main__":
    main()
39. 이 예제에서 일부러 하지 않은 것
실습 코드를 보면:
precompute_ref_log_probs=False로 두었습니다.
처음부터 Memory Optimization 옵션까지 모두 켜면 문제가 생겼을 때 원인을 찾기 어렵기 때문입니다.
첫 실행은 가능한 한 단순하게:
기본 KTO

+

LoRA

+

작은 모델

+

균형 잡힌 Dataset
으로 성공시킨 뒤 옵션을 하나씩 추가하는 편이 좋습니다.
40. 학습된 Adapter 불러오기
import torch

from peft import (
    AutoPeftModelForCausalLM
)

from transformers import (
    AutoTokenizer
)


MODEL_PATH = (
    "models/"
    "python-tutor-kto-lora"
)


tokenizer = (
    AutoTokenizer
    .from_pretrained(
        MODEL_PATH
    )
)


model = (
    AutoPeftModelForCausalLM
    .from_pretrained(
        MODEL_PATH
    )
)
Device 선택:
def select_device():
    if torch.cuda.is_available():
        return torch.device(
            "cuda"
        )

    if (
        hasattr(
            torch.backends,
            "mps"
        )
        and torch.backends.mps.is_available()
    ):
        return torch.device(
            "mps"
        )

    return torch.device(
        "cpu"
    )


device = select_device()

model = model.to(
    device
)

model.eval()
41. KTO 학습 후 실제 답변 생성하기
def generate_answer(
    question: str
) -> str:
    messages = [
        {
            "role": "system",
            "content": SYSTEM_MESSAGE
        },
        {
            "role": "user",
            "content": question
        }
    ]

    input_ids = (
        tokenizer.apply_chat_template(
            messages,

            tokenize=True,

            add_generation_prompt=True,

            return_tensors="pt"
        )
        .to(
            device
        )
    )

    with torch.inference_mode():
        output_ids = (
            model.generate(
                input_ids=input_ids,

                max_new_tokens=256,

                do_sample=False,

                eos_token_id=(
                    tokenizer.eos_token_id
                ),

                pad_token_id=(
                    tokenizer.pad_token_id
                )
            )
        )

    generated_ids = (
        output_ids[
            0,
            input_ids.shape[-1]:
        ]
    )

    return tokenizer.decode(
        generated_ids,
        skip_special_tokens=True
    ).strip()
실행:
answer = generate_answer(
    "None과 숫자 0은 같은 값인가요?"
)

print(
    answer
)
42. KTO 전후 비교는 이렇게 하는 것이 좋다
학습 전 모델과 KTO 모델에 같은 질문을 넣습니다.
예:
None은 어떻게 비교하나요?

가상환경을 왜 사용하나요?

while 문에서 무한 반복은 왜 발생하나요?

set과 list는 어떤 차이가 있나요?

return과 print는 같은 기능인가요?
그리고 단순히:
문장이 더 자연스러운가?만 보지 않습니다.
다음 항목을 별도로 평가합니다.
| 평가 항목 | Base | KTO |
|---|---|---|
| --------- | ---: | --: |
| 사실 정확성 | 측정 | 측정 |
| 질문 직접 답변 | 측정 | 측정 |
| 설명 길이 적절성 | 측정 | 측정 |
| 잘못된 단정 감소 | 측정 | 측정 |
| 코드 정확성 | 측정 | 측정 |
| 사람 선호도 | 측정 | 측정 |
가능하면 모델 이름을 숨기고 평가합니다.
Answer A

vs

Answer B
중 어느 쪽이 좋은지만 평가한 뒤 나중에 Model ID를 공개하는 방식입니다.
43. 좋아요 Dataset에서 꼭 별도로 테스트해 볼 것
실서비스 Feedback을 KTO에 사용한다면 저는 다음 Test Set을 별도로 만들겠습니다.
기존 좋아요 유형
모델이 실제 Positive Feedback 패턴을 잘 유지하는지 확인합니다.
기존 싫어요 유형
Negative Feedback을 받던 행동이 줄었는지 봅니다.
전혀 새로운 질문
Training Feedback을 외운 것이 아닌지 확인합니다.
안전 관련 질문
사용자 만족도 최적화 때문에 안전한 거절 행동이 무너지는지 확인합니다.
짧은 질문
답변이 필요 이상으로 장황해지지 않는지 봅니다.
코드 질문
자연스러운 설명보다 실제 실행 가능성을 확인합니다.
자동 Preference Optimization을 해도 마지막에는 결국 원래 서비스 목표와 맞는지를 사람이 확인해야 합니다.
44. KTO의 장점
KTO를 쓰면서 가장 매력적으로 느껴지는 부분은 Dataset 수집 방식입니다.
DPO를 위해서는:
같은 Prompt

+

답변 A

+

답변 B

+

둘 중 어느 쪽이 더 좋은가?
라는 비교 과정이 필요합니다.
KTO는:
Prompt

+

Response

+

좋았나?
이면 됩니다.
사용자가 이미 서비스에서 남기는 행동 데이터를 활용하기 쉬운 구조입니다. KTO 논문 자체도 Pairwise Preference보다 Binary Desirability Signal만 요구한다는 점을 핵심 특징으로 제시합니다.
45. KTO의 단점도 분명하다
세밀한 순위를 잃는다
아주 좋은 답변

좋은 답변
이 둘이 모두:
True가 될 수 있습니다.
Feedback Noise에 민감하다
사용자가 실수로 👎를 누를 수도 있습니다.
사용자 만족도와 정답이 다를 수 있다
친절하지만 틀린 답변이 👍를 받을 수도 있습니다.
서비스 UI의 영향을 받는다
버튼 위치나 노출 방식이 Feedback 비율에 영향을 줄 수 있습니다.
Feedback을 남기는 사람만 데이터에 잡힌다
아무 버튼도 누르지 않는 대부분의 사용자는 Dataset에서 사라질 수 있습니다.
이것을 Selection Bias 관점에서도 생각해야 합니다.
46. “좋아요가 없는 답변”은 싫어요가 아니다
서비스 로그를 만들 때 특히 조심해야 합니다.
좋아요 없음을 자동으로:
label=False로 바꾸면 안 됩니다.
사용자가:
답변 읽음

↓

문제 해결

↓

그냥 창 닫음
했을 수도 있습니다.
따라서:
명시적인 👍

→ True


명시적인 👎

→ False


아무 Feedback 없음

→ 학습 Dataset 제외
가 기본적으로 더 안전한 출발점입니다.
47. 재생성 버튼도 곧바로 싫어요로 보면 안 된다
사용자가:
Regenerate를 눌렀다고 해서 첫 답변이 무조건 나쁜 것은 아닙니다.
사용자는 단순히:
다른 표현이 궁금해서

좀 더 긴 답이 필요해서

다른 코드 예제를 보고 싶어서
재생성했을 수도 있습니다.
행동 로그를 Preference Label로 바꿀 때는 사용자의 행동과 평가를 구분해야 합니다.
이런 사소한 구분이 실제 Alignment Dataset의 품질을 크게 좌우합니다.
48. 개인정보도 잊으면 안 된다
Chatbot Feedback Dataset에는 의외로 민감한 정보가 쉽게 들어옵니다.
이름

이메일

전화번호

회사 내부 정보

IP

주민번호

계정 정보

API Key

소스코드

내부 URL
같은 정보가 Prompt나 Response에 포함될 수 있습니다.
KTO 학습 전에 최소한:
PII 탐지

↓

마스킹

↓

Access Control

↓

Dataset Version 관리

↓

학습 목적 검토
과정을 마련하는 편이 좋습니다.
특히 외부 Hub에 Dataset이나 Adapter를 올린다면 더 주의해야 합니다.
49. KTO 학습 파이프라인을 서비스에 연결하면
실제 서비스 흐름은 이런 모습이 될 수 있습니다.
사용자 질문

↓

AI 답변

↓

👍 / 👎

↓

Feedback DB

↓

정기적인 데이터 정제

↓

KTO Dataset 생성

↓

Validation

↓

KTO Fine-tuning

↓

Offline Evaluation

↓

Canary Test

↓

새 모델 배포
여기서 중요한 것은:
👍 클릭

↓

즉시 모델 학습
구조로 만들지 않는 것입니다.
Feedback은 먼저 검증해야 합니다.
잘못된 클릭 몇 개보다 더 무서운 것은 자동화된 잘못된 학습 루프입니다.
50. KTOTrainer에서 자주 만날 수 있는 문제
per_device_train_batch_size=1
기본 KTO Loss에서는 문제가 됩니다.
Actual Batch Size가 1이면

다른 Completion을 이용한
KL 추정이 제대로 되지 않음
현재 구현은 이 경우 오류를 발생시킵니다.
해결:
per_device_train_batch_size=4부터 검토합니다.
Learning Rate를 너무 크게 설정했다
예:
learning_rate=1e-4KTO에서는 상당히 공격적인 값입니다.
현재 공식 권장 범위를 참고해 먼저:
learning_rate=1e-6주변에서 실험하는 편이 좋습니다.
Positive 데이터만 있다
이론적으로는 Positive와 Negative가 모두 존재하는 Dataset이 바람직합니다.
현재 공식 문서는 한쪽 Label만으로 학습한 사례도 있다고 언급하지만, 특히 Negative만 사용할 경우 보수적인 Learning Rate를 권장합니다.
가능하다면:
👍

+

👎
를 모두 확보하는 편이 좋습니다.
Positive가 지나치게 많다
먼저 Label 분포를 출력합니다.
print_stats(
    "TRAIN",
    train_dataset
)
그 뒤 필요하다면:
desirable_weight=1.0
undesirable_weight=3.0
등을 실험합니다.
KTO Loss가 0 또는 이상한 값으로 움직인다
다음 순서로 봅니다.
Label이 Boolean인가?

Completion이 비어 있지 않은가?

실제 Batch가 2 이상인가?

Learning Rate가 너무 높지 않은가?

Chat Template이 정상인가?

Positive / Negative가 모두 존재하는가?

잘못된 Padding이 없는가?
Chat Template이 적용되지 않는다
Conversational Format인지 확인합니다.
print(
    train_dataset[0]
)
형태:
{
    "prompt": [
        {
            "role": "user",
            "content": "..."
        }
    ],

    "completion": [
        {
            "role": "assistant",
            "content": "..."
        }
    ],

    "label": True
}
현재 KTOTrainer는 이런 Conversational Dataset에 Chat Template을 자동 적용합니다.
LoRA Target Module 오류
모델마다 Layer 이름이 다릅니다.
Qwen 계열에서는 흔히:
target_modules=[
    "q_proj",
    "k_proj",
    "v_proj",
    "o_proj"
]
를 사용할 수 있지만 다른 Model Family에서는 다를 수 있습니다.
모델 구조를 확인합니다.
for name, module in (
    trainer.model.named_modules()
):
    if "proj" in name:
        print(name)
GPU 메모리가 부족하다
다음 순서로 줄여 봅니다.
max_length 감소

LoRA Rank 감소

QLoRA 사용

Activation Offloading 검토

Reference Log Probability 사전 계산
다만 KTO 기본 Loss에서는 실제 Step Batch를 1까지 줄이는 방식은 적절하지 않습니다.
51. KTO에서 기억할 숫자 몇 개
현재 기본값 기준으로 기억해 둘 만한 값은 다음 정도입니다.
beta

0.1


learning_rate

1e-6


max_length

1024


desirable_weight

1.0


undesirable_weight

1.0
숫자를 외우는 것이 목적은 아닙니다.
업그레이드할 때 Default가 바뀔 수 있으므로 실제 설치 버전의 Config를 확인하는 습관이 더 중요합니다.
52. 실무에서는 알고리즘보다 Dataset 정의서가 먼저다
KTO를 도입한다고 하면 개발자는 먼저 이런 것을 생각하기 쉽습니다.
GPU 몇 장?

LoRA Rank?

Beta?

Epoch?

Batch Size?
그런데 실제 프로젝트라면 그보다 먼저 다음 문서를 만들겠습니다.
Feedback Label Definition예를 들면:
Positive
사용자가 명시적으로
답변 도움됨 버튼을 누른 경우
Negative
사용자가 명시적으로
답변 도움 안 됨 버튼을 누른 경우
제외
아무 Feedback 없음

UI 오류

Response Generation 실패

Spam

Bot Traffic

Feedback 취소

안전 정책 관련 별도 Review 대상
이렇게 Label의 의미가 먼저 정해져야 합니다.
그 다음이 KTOTrainer입니다.
53. KTO가 특히 현실적인 이유
DPO를 공부할 때 데이터 생성 과정을 보면 이런 고민이 생깁니다.
같은 Prompt에 대해

두 답변을 어떻게 준비하지?


누가 비교하지?


평가자는 몇 명 필요하지?
KTO는 이미 운영 중인 서비스가 있다면 상황이 달라집니다.
서비스는 매일:
사용자 질문

AI 답변

Feedback
을 생성합니다.
즉 서비스 자체가 Preference Data 수집 장치가 될 수 있습니다.
KTO가 Pairwise Preference 대신 Binary Desirability Signal만 요구한다는 특징이 실무적으로 의미가 있는 이유입니다.
다만 한 가지는 꼭 기억해야 합니다.
많은 데이터

≠

좋은 데이터
10만 개의 애매한 👎보다 5천 개의 잘 정의된 Feedback이 더 유용할 수 있습니다.
54. 한 번에 정리하는 DPO와 KTO
| 구분 | DPO | KTO |
|---|---|---|
| 기본 데이터 | Prompt + Chosen + Rejected | Prompt + Completion + Label |
| Pair 필요 | 필요 | 불필요 |
| Feedback 형태 | A와 B 중 선택 | 좋아요·싫어요 |
| Offline 학습 | 가능 | 가능 |
| Reference Policy | 사용 | 사용 |
| 실제 서비스 로그 활용 | 추가 가공 필요 | 비교적 자연스러움 |
| 데이터 수집 난이도 | 상대적으로 높음 | 상대적으로 낮을 수 있음 |
| 세밀한 상대 순위 | 표현 가능 | Binary Label에서는 제한 |
| TRL Trainer | DPOTrainer | KTOTrainer |
현재 TRL Dataset 가이드에서도 DPOTrainer는 Preference Dataset을, KTOTrainer는 Unpaired Preference 또는 Preference Dataset을 받을 수 있도록 구분하고 있습니다.
55. 이번 편 핵심만 다시 잡아보면
KTO를 처음 보면 수식부터 읽기 쉽습니다.
하지만 실제로 기억할 것은 훨씬 단순합니다.
Prompt

+

Completion

+

좋았는가?
Dataset:
{
    "prompt": "...",

    "completion": "...",

    "label": True
}
또는:
{
    "prompt": "...",

    "completion": "...",

    "label": False
}
Trainer:
from trl import (
    KTOConfig,
    KTOTrainer
)


trainer = KTOTrainer(
    model=MODEL_ID,

    args=training_args,

    train_dataset=train_dataset,

    peft_config=lora_config
)


trainer.train()
이것이 기본 골격입니다.
56. 마무리
KTO를 공부하고 나면 서비스 화면의 작은 👍 👎 버튼이 조금 다르게 보입니다.
예전에는 그냥:
사용자 만족도 조사정도로 보였다면,
이제는:
Alignment Dataset 후보로도 보입니다.
하지만 버튼 하나를 Training Label 하나로 바꾸는 사이에는 생각보다 많은 일이 필요합니다.
사용자 행동

↓

Feedback 의미 해석

↓

Noise 제거

↓

중복 처리

↓

개인정보 제거

↓

Label 정의

↓

데이터 균형 확인

↓

KTO Dataset

↓

Fine-tuning

↓

독립 평가
KTOTrainer 자체를 실행하는 코드는 어렵지 않습니다.
오히려 어려운 부분은:
이 좋아요가 정말 무엇을 의미하는가?
를 결정하는 일입니다.
사용자가 👍를 눌렀다고 해서 반드시 사실적으로 완벽한 답변은 아닙니다.
사용자가 👎를 눌렀다고 해서 반드시 나쁜 답변도 아닙니다.
때로는 사용자가 듣고 싶지 않은 정확한 답을 해서 싫어요를 받을 수도 있고, 듣기 좋은 틀린 답을 해서 좋아요를 받을 수도 있습니다.
그래서 KTO를 단순히:
👍 많이 먹은 답변 따라 하기라고 이해하면 아쉽습니다.
KTO의 진짜 활용 포인트는 비교 Pair를 만들기 어려운 현실의 Binary Feedback을 언어 모델 Alignment에 연결할 수 있다는 것입니다.
DPO가 이런 질문을 했다면:
“A와 B 중
누가 더 잘했나요?”
KTO는 훨씬 현실적인 질문을 합니다.
“방금 이 답변,

괜찮았나요?”
서비스에서는 후자의 질문에 답해 주는 사용자가 훨씬 많을 수 있습니다.
그리고 그 작은 클릭들이 충분히 잘 정제된다면 모델의 다음 버전을 만드는 학습 신호가 될 수 있습니다.
사용자:

👍


데이터 엔지니어:

“한 건 들어왔네요.”


KTOTrainer:

“좋습니다.

그런데 일단
이 좋아요가 믿을 만한지부터
확인하고 오시죠.”
이 정도의 신중함이 실제 Preference Learning에서는 꽤 중요합니다.
다음 편 예고
[Python 완전정복 시리즈 #46] BCOTrainer 완벽 이해하기 | 좋아요와 싫어요 데이터를 분류 문제처럼 학습해 AI를 정렬하는 방법
KTO까지 살펴봤다면 자연스럽게 이런 질문이 생깁니다.
좋아요

싫어요
라는 Binary Feedback이 있다면,
이 문제를 조금 더 직접적으로:
Positive

vs

Negative
분류 문제처럼 접근할 수도 있지 않을까요?
다음 편에서는 Binary Classifier Optimization, BCO를 살펴보겠습니다.
KTO와 마찬가지로 Unpaired Preference Data를 사용할 수 있지만 접근 방식은 다릅니다.
KTO

→ Prospect Theory 기반 Utility


BCO

→ Binary Classification 관점
같은:
prompt

completion

label
데이터를 두고도 학습 방법이 어떻게 달라지는지 비교해 보겠습니다.
Preference Optimization의 세계가 이제 꽤 재미있어지기 시작합니다.
#Python #파이썬 #Python강좌 #HuggingFace #TRL #KTO #KTOTrainer #KahnemanTverskyOptimization #PreferenceLearning #UnpairedPreference #AI파인튜닝 #LLM #생성형AI #좋아요데이터 #사용자피드백 #AI정렬 #Alignment #LoRA #QLoRA #PEFT #Transformers #FineTuning #DPO #RewardModel #PostTraining #Chatbot #머신러닝 #딥러닝 #PyTorch #코딩공부 #프로그래밍