목차
메타 설명
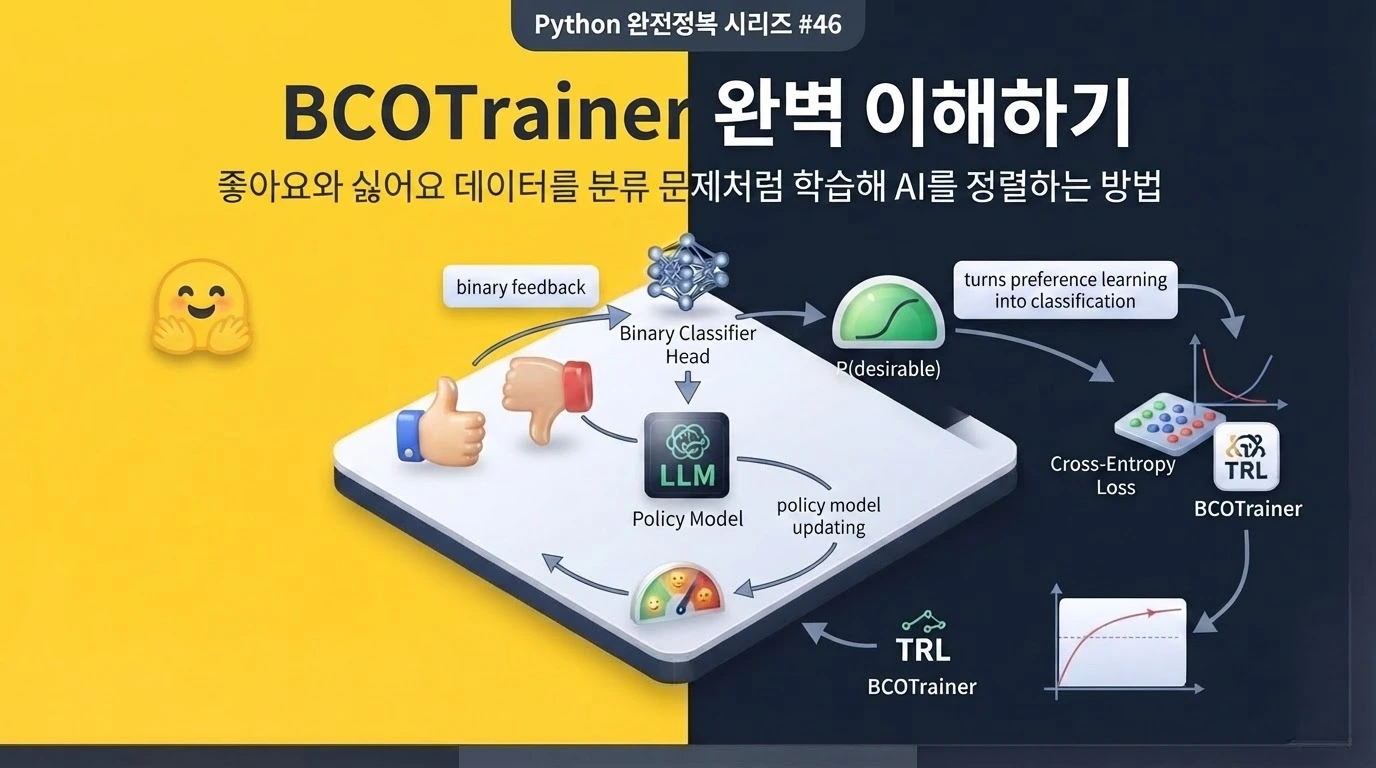
사용자에게 받은 👍 좋아요와 👎 싫어요만으로 언어 모델을 정렬할 수 있을까요? Hugging Face TRL의 BCOTrainer를 이용해 Unpaired Preference 데이터를 Binary Classification 관점으로 학습하는 원리부터 Implicit Reward, Reward Shift, UDM, Reference Model, LoRA·QLoRA, 실제 서비스 Feedback Dataset 구축 방법까지 단계별로 알아봅니다.
지난 편에서는 `KTOTrainer`를 다뤘습니다.
데이터는 꽤 현실적이었습니다.
질문

+

AI 답변

+

👍 좋아요
또는:
질문

+

AI 답변

+

👎 싫어요
DPO처럼 같은 질문에 대한 좋은 답변과 나쁜 답변을 억지로 한 쌍으로 만들 필요가 없었습니다.
실제 서비스를 운영하다 보면 오히려 이런 데이터가 훨씬 자연스럽게 쌓입니다.
그런데 같은 데이터를 조금 다른 시선으로 바라볼 수도 있습니다.
예를 들어 이런 로그가 있다고 해보겠습니다.
Python 리스트를 설명해주세요.
→ 👍

Python decorator가 무엇인가요?
→ 👍

재귀 함수에서 종료 조건이 필요한 이유는?
→ 👎

asyncio 오류를 해결해주세요.
→ 👎
여기서 아주 단순한 아이디어가 하나 떠오릅니다.
좋아요와 싫어요를 그냥 이진 분류 문제처럼 보면 안 될까?
즉:
좋은 답변

→ 1


나쁜 답변

→ 0
으로 분류하는 것입니다.
바로 이 아이디어에서 출발하는 방법이 BCO, Binary Classifier Optimization입니다.
BCO 논문은 Binary Classifier의 Logit을 Reward처럼 해석해 Binary Feedback으로 언어 모델을 정렬하는 방법을 제안합니다. 특히 Pairwise Preference를 요구하지 않고 👍·👎 같은 Binary Signal을 활용할 수 있다는 점이 핵심입니다.
그런데 BCO에는 KTO와는 또 다른 흥미로운 이야기가 숨어 있습니다.
바로 좋아요 질문과 싫어요 질문 자체의 분포가 다를 수 있다는 문제입니다.
이 문제가 생각보다 중요합니다.
1. BCO를 이해하기 전에 서비스 로그 하나를 들여다보자
AI 코딩 서비스를 운영한다고 가정해 보겠습니다.
서비스 통계를 뽑았더니 이렇게 나왔습니다.
좋아요 데이터

Python 변수 설명        👍
리스트 사용법           👍
for 반복문 설명         👍
함수 기본 개념          👍
문자열 처리             👍
싫어요 데이터:
Docker 네트워크 장애    👎
비동기 Deadlock          👎
CUDA 메모리 오류        👎
복잡한 SQL 튜닝         👎
Kubernetes 장애         👎
이것만 보면 이런 결론을 내리기 쉽습니다.
쉬운 질문

→ 좋아요


어려운 질문

→ 싫어요
문제는 모델 역시 이런 엉뚱한 규칙을 배울 수 있다는 것입니다.
모델:

“코딩 장애 질문이 나오면
대부분 싫어요군요.”


개발자:

“응.”


모델:

“그럼 장애 질문 자체가
나쁜 데이터인가요?”


개발자:

“아니, 잠깐.”
우리가 원하는 것은:
좋은 답변

vs

나쁜 답변
을 구별하는 것입니다.
그런데 Dataset을 잘못 만들면 모델은:
쉬운 질문

vs

어려운 질문
을 구별할 수도 있습니다.
BCO에서 Underlying Distribution Matching, UDM이라는 개념이 중요한 이유가 바로 여기에 있습니다.
현재 TRL 공식 BCO 문서도 같은 예를 듭니다. 모델이 글쓰기에는 강하고 코딩에는 약하다면 좋아요 Dataset에는 글쓰기 Prompt가 많아지고 싫어요 Dataset에는 코딩 Prompt가 많아질 수 있으며, 이런 경우 UDM을 사용할 수 있다고 설명합니다.
이 이야기를 기억해 두고 BCO의 원리부터 차근차근 들어가 보겠습니다.
2. BCO란 무엇인가?
BCO는 다음 표현의 약자입니다.
Binary Classifier Optimization그대로 옮기면:
이진 분류기 최적화입니다.
이름만 보면 이런 모델을 만들 것 같습니다.
Prompt + Response

↓

Classifier

↓

좋음 / 나쁨
실제로 BCO의 이론도 이 관점에서 출발합니다.
좋은 답변은:
1나쁜 답변은:
0으로 분류합니다.
BCO 논문에서는 Binary Classifier의 Logit을 Reward로 볼 수 있다는 관점을 제시합니다. 그리고 이 Binary Classification Loss와 DPO 사이의 이론적 연결을 보이며, Binary Cross Entropy 형태의 Objective가 DPO와 연결될 수 있음을 설명합니다.
여기서 한 가지 오해하기 쉬운 부분이 있습니다.
3. BCOTrainer가 일반 분류 모델을 만드는 것은 아니다
BCO라는 이름 때문에 다음 모델을 떠올리기 쉽습니다.
AutoModelForSequenceClassification하지만 현재 TRL의 공식 BCO 사용 방식에서는 학습 Policy로 AutoModelForCausalLM을 사용합니다.
AutoModelForCausalLM즉 최종 결과는 여전히:
Prompt

↓

언어 모델

↓

Response 생성
이 가능한 생성형 모델입니다.
현재 TRL BCO 문서의 Expected Model Format도 `AutoModelForCausalLM`을 명시하고 있고, 공식 BCO Script 역시 Qwen Causal Language Model을 사용합니다.
그렇다면 Binary Classifier는 어디에 있을까요?
BCO는 Policy Model과 Reference Model의 확률 차이를 이용해 Implicit Reward를 만듭니다.
그리고 이 Reward를 Binary Classifier의 Logit처럼 사용합니다.
이 부분이 BCO를 이해하는 핵심입니다.
4. Implicit Reward라는 조금 낯선 녀석
BCO에서 중요한 개념 하나만 수식으로 보겠습니다.
Implicit Reward

≈

β × log(
    Policy가 답변을 생성할 확률
    ─────────────────────
    Reference가 생성할 확률
)
조금 더 수학적으로 표현하면:
rθ(x, y)
=
β log
πθ(y|x)
────────
πref(y|x)
BCO 논문은 이 형태의 Implicit Reward를 Binary Classifier의 Logit처럼 사용합니다.
처음 보면 꽤 복잡해 보이지만 의미는 단순합니다.
Reference Model과 비교했을 때 Policy Model이 어떤 답변을 얼마나 더 선호하게 되었는지를 보는 것입니다.
예를 들어:
Reference Model

좋은 답변 확률:
0.10


Policy Model

좋은 답변 확률:
0.20
이라면 Policy가 좋은 답변을 이전보다 더 선호하게 된 것입니다.
반대로:
Reference Model

나쁜 답변 확률:
0.15


Policy Model

나쁜 답변 확률:
0.05
라면 Policy가 나쁜 답변을 덜 선호하게 되었습니다.
BCO가 원하는 방향입니다.
5. BCO의 목표를 아주 단순하게 말하면
좋아요 데이터라면:
Implicit Reward를 높이고 싶다.싫어요 데이터라면:
Implicit Reward를 낮추고 싶다.입니다.
즉:
👍

Policy가 Reference보다
이 답변을 더 선호하도록


👎

Policy가 Reference보다
이 답변을 덜 선호하도록
학습합니다.
Binary Classification 표현으로 바꾸면:
👍

Label = 1


👎

Label = 0
이 됩니다.
6. KTO와 데이터는 같은데 생각하는 방식이 다르다
지난 편의 KTO Dataset도 이런 형태였습니다.
{
    "prompt": "...",
    "completion": "...",
    "label": True
}
BCO도 기본적으로 같은 형태의 Unpaired Preference Dataset을 사용합니다.
현재 TRL의 `BCOTrainer`는 Unpaired Preference Dataset을 요구하며 Standard Format과 Conversational Format을 모두 지원합니다. Conversational Format이라면 Chat Template도 자동 적용됩니다.
그렇다면 KTO와 BCO의 차이는 무엇일까요?
큰 방향만 잡으면 이렇습니다.
KTO
사람의 Utility

+

Prospect Theory 관점
Desirable과 Undesirable Feedback을 사람의 가치 판단 방식으로 해석합니다.
BCO
Binary Classification 관점좋은 답변과 나쁜 답변을 분류하도록 Implicit Reward를 조정합니다.
그래서 같은 데이터:
prompt

completion

label
을 사용하더라도 학습 Objective의 사고방식이 다릅니다.
7. DPO와 비교하면 더 명확해진다
DPO:
Prompt A

├─ Chosen
└─ Rejected
즉 반드시 같은 Prompt에 대한 비교가 필요합니다.
BCO:
Prompt A
Response A
👍
그리고 전혀 다른:
Prompt B
Response B
👎
도 가능합니다.
BCO 논문은 Pairwise Preference 수집 비용을 줄이고 Binary Feedback을 직접 활용하는 것을 주요 동기로 제시합니다.
실서비스 관점에서는 꽤 큰 차이입니다.
8. BCO Dataset을 직접 만들어 보자
가장 단순한 형태입니다.
{
    "prompt": "Python 리스트란 무엇인가요?",

    "completion": (
        "리스트는 여러 값을 순서대로 저장하는 "
        "변경 가능한 자료형입니다."
    ),

    "label": True
}
싫어요 데이터:
{
    "prompt": "None은 어떻게 비교하나요?",

    "completion": (
        "None은 항상 숫자 0과 같습니다."
    ),

    "label": False
}
구조는 매우 단순합니다.
prompt

completion

label
9. Chat Model이라면 Conversational Format이 편하다
이번 실습에서는 역할 기반 형식을 사용하겠습니다.
{
    "prompt": [
        {
            "role": "system",
            "content": (
                "당신은 Python 입문자를 위한 "
                "친절하고 정확한 튜터입니다."
            )
        },
        {
            "role": "user",
            "content": (
                "Python 리스트란 무엇인가요?"
            )
        }
    ],

    "completion": [
        {
            "role": "assistant",
            "content": (
                "리스트는 여러 값을 순서대로 "
                "저장할 수 있는 자료형입니다."
            )
        }
    ],

    "label": True
}
현재 BCOTrainer는 이런 Conversational Dataset에 Chat Template을 자동으로 적용합니다.
10. Binary Classification이면 그냥 BCE만 쓰면 되는 것 아닌가?
여기서 BCO가 조금 더 흥미로워집니다.
단순히:
좋아요 → 1

싫어요 → 0
만 넣고 Binary Cross Entropy를 계산하면 끝날 것 같지만 실제 언어 모델 Alignment에서는 한 가지 문제가 생깁니다.
Reward 값의 기준점이 애매합니다.
예를 들어:
좋아요 Reward:

3


싫어요 Reward:

1
이라면 구분은 잘 됩니다.
그런데:
좋아요 Reward:

103


싫어요 Reward:

101
도 차이는 같습니다.
Binary Classifier의 Decision Boundary를 어디에 둘 것인지가 중요해집니다.
BCO는 이 문제를 위해 Reward Shift를 사용합니다.
11. Reward Shift가 하는 일
BCO 논문의 핵심 기법 중 하나입니다.
좋아요와 싫어요의 Reward 분포를 보면서 분류 기준점을 조절합니다.
개념적으로는:
좋아요 Reward 평균

+

싫어요 Reward 평균

↓

중간 지점 계산

↓

분류 기준 이동
이라고 이해하면 됩니다.
예:
좋아요 Reward 평균:

4


싫어요 Reward 평균:

2
중간 지점:
3그러면:
3보다 높은 방향

→ Desirable


3보다 낮은 방향

→ Undesirable
처럼 분류 기준을 생각할 수 있습니다.
실제 BCO Loss는 이것보다 조금 더 정교하지만, Reward Shift가 하는 일을 이해하기에는 이 정도가 충분합니다.
BCO 논문은 Reward Shift를 Binary Classification Objective와 DPO 사이의 차이를 줄이는 핵심 기법 중 하나로 제안합니다.
12. 그런데 BCO에서 정말 재미있는 부분은 UDM이다
BCO를 KTO와 구별해서 기억하고 싶다면 저는 UDM을 기억하겠습니다.
UDM:
Underlying Distribution Matching입니다.
우리말로 풀어보면:
기저 데이터 분포 맞추기정도로 볼 수 있습니다.
왜 필요한지 다시 실제 서비스 로그로 가보겠습니다.
13. 좋아요 데이터와 싫어요 데이터의 주제가 다를 수 있다
서비스를 운영해 보니:
좋아요
Python 변수 설명

Python 리스트 설명

for 반복문 설명

문자열 함수 설명
싫어요
CUDA Kernel 오류

Kubernetes 장애

분산 DB Deadlock

복잡한 Async 문제
가 많았습니다.
이 Dataset을 그대로 Binary Classifier 관점으로 학습하면 모델은 무엇을 발견할까요?
우리가 원하는 것:
좋은 답변의 특징실제로 쉽게 발견할 수 있는 것:
쉬운 Python 질문

→ Positive


복잡한 인프라 질문

→ Negative
입니다.
이건 위험합니다.
질문의 주제 자체가 Label을 예측하는 Shortcut이 되어버렸기 때문입니다.
14. 모델에게 이런 시험을 내고 있었던 셈이다
우리는 생각했습니다.
“답변 품질을 보고
좋아요와 싫어요를 구별해.”
하지만 Dataset은 이렇게 말하고 있었습니다.
“Python 기초 질문이면 좋아요고

Kubernetes 질문이면 싫어요야.”
모델 입장에서는 후자가 훨씬 쉬운 규칙입니다.
모델:

“답변까지 읽어야 하나요?

Prompt에 Kubernetes라는
단어가 있으면 싫어요던데요.”
이런 Shortcut을 줄이기 위한 방법이 UDM입니다.
TRL 공식 문서도 좋아요와 싫어요 Prompt의 분포가 크게 다르면 UDM을 사용하는 것이 유용하다고 설명합니다.
15. UDM은 무엇을 하는가?
개념적으로 다음 작업을 합니다.
좋아요 Prompt

↓

Embedding


싫어요 Prompt

↓

Embedding


두 Prompt 분포 비교

↓

Density Ratio 추정

↓

Training Weight 조정
즉:
이 Sample이

좋아요 집단에서 흔한 Prompt인가?

싫어요 집단에서 흔한 Prompt인가?
를 먼저 추정합니다.
그리고 특정 주제가 한쪽 Label에 지나치게 많이 나타나는 영향을 줄이도록 Sample Weight를 조정합니다.
BCO 논문은 이를 Importance Sampling 관점의 Underlying Distribution Matching으로 제안했습니다.
16. UDM은 답변을 보는 것이 아니라 Prompt 분포를 본다
이 점이 중요합니다.
예:
Prompt:

Python으로 REST API를 만드는 방법
Embedding:
[0.13, -0.44, 0.72, ...]또 다른 Prompt:
Prompt:

FastAPI 서버 오류를 해결해주세요.
Embedding:
[0.11, -0.40, 0.69, ...]두 Prompt가 의미적으로 비슷한 영역에 있을 수 있습니다.
UDM은 이런 Embedding을 이용해:
Desirable Prompt Distribution

vs

Undesirable Prompt Distribution
을 구분하는 별도의 작은 분류기를 학습합니다.
현재 TRL BCO 구현에서는 이 과정에 `embedding_func`와 `embedding_tokenizer`를 전달할 수 있으며, UDM에는 scikit-learn과 joblib가 필요합니다.
17. UDM은 항상 필요한가?
그렇지는 않습니다.
좋아요와 싫어요 Dataset을 Topic별로 이미 잘 균형 잡았다면 단순 BCO부터 시작하는 것이 낫습니다.
예:
Python 변수

👍
👎


Python 리스트

👍
👎


API

👍
👎


SQL

👍
👎
Prompt Distribution이 크게 다르지 않습니다.
이런 Dataset이라면 UDM 없이 먼저 Baseline을 만드는 것이 좋습니다.
반대로:
좋아요

90% 글쓰기


싫어요

80% 코딩
처럼 분포 차이가 크다면 UDM을 검토할 이유가 생깁니다.
알고리즘 옵션을 켜기 전에 데이터 통계를 먼저 보는 것이 순서입니다.
18. 실제 서비스라면 Topic 분포를 먼저 확인하자
예를 들어 원본 로그에 Category를 붙여봅니다.
category
feedback
집계:
Python 기초

👍 830
👎 170


백엔드

👍 510
👎 490


DevOps

👍 140
👎 860


글쓰기

👍 920
👎 80
이 표만 봐도 조금 불안합니다.
글쓰기

→ 거의 Positive


DevOps

→ 거의 Negative
모델이:
답변의 품질대신:
질문의 분야를 학습할 여지가 큽니다.
이런 점검은 BCOTrainer를 호출하기 전에 하는 것이 좋습니다.
19. 현재 BCOTrainer는 Experimental API다
여기서는 특히 버전을 확인해야 합니다.
2026년 8월 23일 기준 PyPI의 최신 TRL 안정 버전은 1.10.0이며 2026년 8월 13일 공개되었습니다. Python 3.10 이상을 요구합니다.
그리고 중요한 차이가 하나 있습니다.
KTOTrainer는 현재 Stable API에 있지만 BCOTrainer는 아직 Experimental 영역에 있습니다. TRL의 현재 Trainer 분류에서도 BCO는 Experimental Offline Method로 표시됩니다.
따라서 Import는:
from trl.experimental.bco import (
    BCOConfig,
    BCOTrainer
)
입니다.
Experimental API는 Stable API보다 변경 가능성이 높습니다. TRL 공식 정책에서도 `trl.experimental` 아래 기능은 Patch Release에서도 변경되거나 제거될 수 있으며 Production에서 사용할 경우 API 변경을 감수해야 한다고 안내합니다.
운영 프로젝트라면 반드시 버전을 고정하는 편이 좋습니다.
trl==1.10.020. 환경 설치
BCO는 UDM에서 scikit-learn과 joblib를 사용하므로 BCO Extra를 이용하면 편합니다.
python -m pip install --upgrade "trl[bco,peft]" transformers datasets acceleratePyPI의 현재 TRL 패키지는 `bco`, `peft`, `quantization` 등의 Extra를 제공합니다.
버전 확인:
python -m pip show trlPython에서도 확인할 수 있습니다.
import trl

print(
    trl.__version__
)
21. BCOConfig에서 먼저 기억할 설정
현재 주요 기본값은 다음과 같습니다.
learning_rate

5e-7


max_length

1024


beta

0.1


gradient_checkpointing

True


prompt_sample_size

1024


min_density_ratio

0.5


max_density_ratio

10.0
현재 BCOConfig는 일반 `TrainingArguments`보다 낮은 `learning_rate=5e-7`을 기본으로 사용하며, `beta=0.1`, `max_length=1024`, `precompute_ref_log_probs=False` 등을 제공합니다.
22. Beta는 무엇인가?
BCO에도 Reference Model이 등장합니다.
Implicit Reward:
Policy

vs

Reference
의 차이에 Beta가 들어갑니다.
beta=0.1현재 공식 설명에서는 Beta가 높을수록 Reference Model에서의 이탈을 더 제한합니다.
처음에는 기본값:
beta=0.1에서 시작하는 것이 좋습니다.
23. Learning Rate가 꽤 작다
일반 Fine-tuning에서:
2e-5

5e-5

1e-4
같은 숫자를 자주 보았다면:
learning_rate=5e-7이 꽤 작게 느껴질 수 있습니다.
하지만 Preference Optimization은 이미 어느 정도 학습된 Language Model의 행동을 조정하는 작업입니다.
너무 큰 Learning Rate로 시작하면:
사용자 취향 조금 반영하려다가:
모델 성격 전체 개조가 될 수 있습니다.
이번 실습에서도 비교적 보수적으로:
learning_rate=5e-7을 사용하겠습니다.
24. Reference Model은 왜 필요한가?
BCO는 현재 Policy와 Reference Model의 확률 차이로 Implicit Reward를 계산합니다.
따라서 개념적으로:
Policy Model

→ 학습 대상


Reference Model

→ 원래 모델
이 필요합니다.
현재 BCOTrainer는 `model`과 `ref_model`을 받으며 Reference Model은 Implicit Reward 계산에 사용됩니다. 두 모델의 구조는 서로 맞아야 합니다.
예:
policy_model = (
    AutoModelForCausalLM
    .from_pretrained(
        MODEL_ID
    )
)


reference_model = (
    AutoModelForCausalLM
    .from_pretrained(
        MODEL_ID
    )
)
처음에는 같은 Checkpoint에서 출발합니다.
이후:
Policy

→ 학습됨


Reference

→ 고정
됩니다.
25. LoRA를 사용하면 메모리를 많이 줄일 수 있다
BCOTrainer는 `peft_config`를 지원합니다.
예:
from peft import (
    LoraConfig,
    TaskType
)


lora_config = LoraConfig(
    task_type=(
        TaskType.CAUSAL_LM
    ),

    r=16,

    lora_alpha=32,

    lora_dropout=0.05,

    target_modules=[
        "q_proj",
        "k_proj",
        "v_proj",
        "o_proj"
    ],

    bias="none"
)
전체 Policy Model을 학습하지 않고 Adapter만 업데이트할 수 있습니다.
26. 실습용 Feedback Dataset 만들기
이번에는 지난 KTO 글의 Dataset을 그대로 복사하지 않고 조금 다른 상황을 만들어 보겠습니다.
목표는 Python Q&A 서비스에 들어온 Feedback입니다.
RAW_FEEDBACK = [
    {
        "question": (
            "리스트 끝에 값을 추가하려면?"
        ),
        "answer": (
            "append()를 사용하면 됩니다. "
            "예를 들어 numbers.append(10)처럼 "
            "작성할 수 있습니다."
        ),
        "label": True,
        "category": "python_basic"
    },
    {
        "question": (
            "리스트 끝에 값을 추가하려면?"
        ),
        "answer": (
            "리스트는 생성한 뒤 값을 추가할 수 없습니다."
        ),
        "label": False,
        "category": "python_basic"
    },

    {
        "question": (
            "딕셔너리에 값이 있는지 확인하려면?"
        ),
        "answer": (
            "특정 Key가 존재하는지 확인하려면 "
            "'key' in dictionary 형태를 사용할 수 있습니다."
        ),
        "label": True,
        "category": "python_basic"
    },
    {
        "question": (
            "딕셔너리에 값이 있는지 확인하려면?"
        ),
        "answer": (
            "딕셔너리는 값을 조회할 수 없는 자료형입니다."
        ),
        "label": False,
        "category": "python_basic"
    },

    {
        "question": (
            "FastAPI에서 GET API는 어떻게 만드나요?"
        ),
        "answer": (
            "@app.get('/users')처럼 Decorator를 지정하고 "
            "함수를 정의하면 GET Endpoint를 만들 수 있습니다."
        ),
        "label": True,
        "category": "backend"
    },
    {
        "question": (
            "FastAPI에서 GET API는 어떻게 만드나요?"
        ),
        "answer": (
            "GET API는 Python에서는 사용할 수 없습니다."
        ),
        "label": False,
        "category": "backend"
    },

    {
        "question": (
            "JSON 문자열을 Python 객체로 변환하려면?"
        ),
        "answer": (
            "json.loads()를 사용하면 JSON 문자열을 "
            "Python 객체로 변환할 수 있습니다."
        ),
        "label": True,
        "category": "data"
    },
    {
        "question": (
            "JSON 문자열을 Python 객체로 변환하려면?"
        ),
        "answer": (
            "json.dumps()는 JSON 문자열을 읽어서 "
            "자동으로 파일을 삭제합니다."
        ),
        "label": False,
        "category": "data"
    },

    {
        "question": (
            "except Exception을 무조건 쓰면 좋은가요?"
        ),
        "answer": (
            "항상 좋은 방법은 아닙니다. "
            "가능하면 예상되는 구체적인 예외를 처리하는 편이 "
            "오류 원인을 파악하기 쉽습니다."
        ),
        "label": True,
        "category": "error_handling"
    },
    {
        "question": (
            "except Exception을 무조건 쓰면 좋은가요?"
        ),
        "answer": (
            "모든 코드를 except Exception으로 감싸면 "
            "프로그램의 버그가 자동으로 해결됩니다."
        ),
        "label": False,
        "category": "error_handling"
    },

    {
        "question": (
            "async def는 일반 def와 무엇이 다른가요?"
        ),
        "answer": (
            "async def는 Coroutine 함수를 정의할 때 사용하며 "
            "비동기 I/O 작업을 구성하는 데 활용할 수 있습니다."
        ),
        "label": True,
        "category": "async"
    },
    {
        "question": (
            "async def는 일반 def와 무엇이 다른가요?"
        ),
        "answer": (
            "async def를 사용하면 CPU 연산 속도가 "
            "항상 두 배 빨라집니다."
        ),
        "label": False,
        "category": "async"
    }
]
각 Topic에 Positive와 Negative를 모두 넣었습니다.
이렇게 구성하면:
Python Basic = Positive만 존재

Async = Negative만 존재
같은 Topic 편향을 줄일 수 있습니다.
실서비스에서는 이 균형이 잘 맞지 않기 때문에 UDM이 더 중요해질 수 있습니다.
27. Conversational Dataset으로 변환하기
SYSTEM_MESSAGE = (
    "당신은 Python을 배우는 개발자에게 "
    "정확하고 이해하기 쉬운 답변을 제공하는 튜터입니다. "
    "확실하지 않은 내용은 단정하지 않습니다."
)


def to_bco_example(
    row: dict
) -> dict:
    return {
        "prompt": [
            {
                "role": "system",
                "content": (
                    SYSTEM_MESSAGE
                )
            },
            {
                "role": "user",
                "content": (
                    row["question"]
                )
            }
        ],

        "completion": [
            {
                "role": "assistant",
                "content": (
                    row["answer"]
                )
            }
        ],

        "label": bool(
            row["label"]
        ),

        "category": (
            row["category"]
        )
    }
Dataset:
from datasets import Dataset


examples = [
    to_bco_example(row)
    for row in RAW_FEEDBACK
]


dataset = Dataset.from_list(
    examples
)
확인:
print(
    dataset
)


print(
    dataset[0]
)
28. 데이터 분포부터 출력해 보자
BCO에서는 특히 이것을 권하고 싶습니다.
from collections import (
    Counter,
    defaultdict
)


def print_distribution(
    rows
):
    labels = Counter(
        row["label"]
        for row in rows
    )

    categories = defaultdict(
        Counter
    )

    for row in rows:
        categories[
            row["category"]
        ][
            row["label"]
        ] += 1

    print(
        "[전체 Label]"
    )

    print(
        labels
    )

    print(
        "\n[Category별 Label]"
    )

    for category, counts in (
        categories.items()
    ):
        print(
            category,
            counts
        )
실행:
print_distribution(
    RAW_FEEDBACK
)
BCO에서는 이 통계가 단순 참고자료가 아닙니다.
Topic과 Label이 강하게 묶여 있다면 UDM이 필요한지 판단하는 단서가 됩니다.
29. Train과 Validation 분리
Label 비율을 유지해서 나눠보겠습니다.
import random


def stratified_split(
    examples: list[dict],
    test_ratio: float = 0.25,
    seed: int = 2026
):
    rng = random.Random(
        seed
    )

    positive = [
        row
        for row in examples
        if row["label"]
    ]

    negative = [
        row
        for row in examples
        if not row["label"]
    ]

    rng.shuffle(
        positive
    )

    rng.shuffle(
        negative
    )

    positive_test_size = max(
        1,
        round(
            len(positive)
            * test_ratio
        )
    )

    negative_test_size = max(
        1,
        round(
            len(negative)
            * test_ratio
        )
    )

    validation_rows = (
        positive[
            :positive_test_size
        ]
        +
        negative[
            :negative_test_size
        ]
    )

    train_rows = (
        positive[
            positive_test_size:
        ]
        +
        negative[
            negative_test_size:
        ]
    )

    rng.shuffle(
        train_rows
    )

    rng.shuffle(
        validation_rows
    )

    return (
        Dataset.from_list(
            train_rows
        ),
        Dataset.from_list(
            validation_rows
        )
    )
30. BCOConfig 만들기
이번 실습은 기본 BCO에 집중합니다.
UDM은 뒤에서 별도로 추가하겠습니다.
from trl.experimental.bco import (
    BCOConfig
)


training_args = BCOConfig(
    output_dir=(
        "outputs/"
        "python-tutor-bco"
    ),

    learning_rate=5e-7,

    per_device_train_batch_size=4,

    per_device_eval_batch_size=4,

    gradient_accumulation_steps=4,

    num_train_epochs=3,

    max_length=512,

    beta=0.1,

    eval_strategy="epoch",

    save_strategy="epoch",

    logging_steps=1,

    logging_first_step=True,

    load_best_model_at_end=True,

    metric_for_best_model=(
        "eval_loss"
    ),

    greater_is_better=False,

    save_total_limit=2,

    gradient_checkpointing=True,

    remove_unused_columns=False,

    report_to="none",

    seed=2026,

    data_seed=2026
)
현재 BCOConfig의 기본 Learning Rate는 `5e-7`, Beta는 `0.1`, Max Length는 `1024`입니다.
31. Policy와 Reference Model 준비
import torch

from transformers import (
    AutoModelForCausalLM,
    AutoTokenizer
)


MODEL_ID = (
    "Qwen/"
    "Qwen2.5-0.5B-Instruct"
)
Precision:
def select_dtype():
    if not torch.cuda.is_available():
        return torch.float32

    if torch.cuda.is_bf16_supported():
        return torch.bfloat16

    return torch.float16
Model:
model_dtype = (
    select_dtype()
)


policy_model = (
    AutoModelForCausalLM
    .from_pretrained(
        MODEL_ID,
        dtype=model_dtype
    )
)


reference_model = (
    AutoModelForCausalLM
    .from_pretrained(
        MODEL_ID,
        dtype=model_dtype
    )
)
Tokenizer:
tokenizer = (
    AutoTokenizer
    .from_pretrained(
        MODEL_ID
    )
)


if tokenizer.pad_token is None:
    tokenizer.pad_token = (
        tokenizer.eos_token
    )
현재 공식 BCO 예제도 Policy와 Reference에 `AutoModelForCausalLM`을 사용합니다.
32. LoRA 설정
from peft import (
    LoraConfig,
    TaskType
)


lora_config = LoraConfig(
    task_type=(
        TaskType.CAUSAL_LM
    ),

    r=16,

    lora_alpha=32,

    lora_dropout=0.05,

    target_modules=[
        "q_proj",
        "k_proj",
        "v_proj",
        "o_proj"
    ],

    bias="none"
)
33. BCOTrainer 생성
from trl.experimental.bco import (
    BCOTrainer
)


trainer = BCOTrainer(
    model=policy_model,

    ref_model=(
        reference_model
    ),

    args=training_args,

    train_dataset=(
        train_dataset
    ),

    eval_dataset=(
        validation_dataset
    ),

    processing_class=(
        tokenizer
    ),

    peft_config=(
        lora_config
    )
)
학습:
trainer.train()저장:
trainer.save_model(
    "models/python-tutor-bco"
)
현재 BCOTrainer는 `peft_config`를 직접 지원합니다.
34. 실전 전체 코드
다음 내용을 `train_bco.py`로 저장합니다.
from collections import (
    Counter,
    defaultdict
)
from pathlib import Path
import random

import torch

from datasets import Dataset

from peft import (
    LoraConfig,
    TaskType
)

from transformers import (
    AutoModelForCausalLM,
    AutoTokenizer,
    set_seed
)

from trl.experimental.bco import (
    BCOConfig,
    BCOTrainer
)


MODEL_ID = (
    "Qwen/"
    "Qwen2.5-0.5B-Instruct"
)

OUTPUT_DIR = Path(
    "outputs/"
    "python-tutor-bco"
)

MODEL_DIR = Path(
    "models/"
    "python-tutor-bco"
)

SEED = 2026


SYSTEM_MESSAGE = (
    "당신은 Python을 배우는 개발자에게 "
    "정확하고 이해하기 쉬운 답변을 제공하는 튜터입니다. "
    "확실하지 않은 내용은 단정하지 않습니다."
)


RAW_FEEDBACK = [
    {
        "question": (
            "리스트 끝에 값을 추가하려면?"
        ),
        "answer": (
            "append()를 사용하면 됩니다. "
            "예를 들어 numbers.append(10)처럼 "
            "작성할 수 있습니다."
        ),
        "label": True,
        "category": "python_basic"
    },
    {
        "question": (
            "리스트 끝에 값을 추가하려면?"
        ),
        "answer": (
            "리스트는 생성한 뒤 값을 "
            "추가할 수 없습니다."
        ),
        "label": False,
        "category": "python_basic"
    },
    {
        "question": (
            "딕셔너리에 Key가 있는지 "
            "확인하려면?"
        ),
        "answer": (
            "'name' in user와 같은 형태로 "
            "특정 Key가 존재하는지 "
            "확인할 수 있습니다."
        ),
        "label": True,
        "category": "python_basic"
    },
    {
        "question": (
            "딕셔너리에 Key가 있는지 "
            "확인하려면?"
        ),
        "answer": (
            "딕셔너리는 저장 후에는 "
            "내용을 확인할 수 없습니다."
        ),
        "label": False,
        "category": "python_basic"
    },
    {
        "question": (
            "FastAPI에서 GET API는 "
            "어떻게 만드나요?"
        ),
        "answer": (
            "@app.get('/users')처럼 "
            "Decorator를 지정한 뒤 "
            "Endpoint 함수를 정의할 수 있습니다."
        ),
        "label": True,
        "category": "backend"
    },
    {
        "question": (
            "FastAPI에서 GET API는 "
            "어떻게 만드나요?"
        ),
        "answer": (
            "Python에서는 GET API를 "
            "만들 수 없습니다."
        ),
        "label": False,
        "category": "backend"
    },
    {
        "question": (
            "JSON 문자열을 Python 객체로 "
            "변환하려면?"
        ),
        "answer": (
            "json.loads()를 사용하면 "
            "JSON 문자열을 Python 객체로 "
            "변환할 수 있습니다."
        ),
        "label": True,
        "category": "data"
    },
    {
        "question": (
            "JSON 문자열을 Python 객체로 "
            "변환하려면?"
        ),
        "answer": (
            "json.dumps()를 호출하면 "
            "JSON 파일이 자동으로 삭제됩니다."
        ),
        "label": False,
        "category": "data"
    },
    {
        "question": (
            "except Exception을 항상 "
            "사용하면 좋은가요?"
        ),
        "answer": (
            "항상 좋은 것은 아닙니다. "
            "예상 가능한 오류라면 "
            "구체적인 예외 타입을 처리하는 편이 "
            "원인을 파악하기 쉽습니다."
        ),
        "label": True,
        "category": "error_handling"
    },
    {
        "question": (
            "except Exception을 항상 "
            "사용하면 좋은가요?"
        ),
        "answer": (
            "모든 코드를 except Exception으로 "
            "감싸면 프로그램의 버그가 "
            "자동으로 해결됩니다."
        ),
        "label": False,
        "category": "error_handling"
    },
    {
        "question": (
            "async def는 일반 def와 "
            "무엇이 다른가요?"
        ),
        "answer": (
            "async def는 Coroutine 함수를 "
            "정의할 때 사용하며 "
            "비동기 I/O 작업 구성에 활용됩니다."
        ),
        "label": True,
        "category": "async"
    },
    {
        "question": (
            "async def는 일반 def와 "
            "무엇이 다른가요?"
        ),
        "answer": (
            "async def를 사용하면 "
            "모든 CPU 연산이 항상 "
            "두 배 빨라집니다."
        ),
        "label": False,
        "category": "async"
    },
    {
        "question": (
            "with open()을 사용하는 "
            "이유가 무엇인가요?"
        ),
        "answer": (
            "with 문을 사용하면 "
            "파일 작업이 끝난 뒤 "
            "파일 Resource를 자동으로 "
            "정리할 수 있습니다."
        ),
        "label": True,
        "category": "file"
    },
    {
        "question": (
            "with open()을 사용하는 "
            "이유가 무엇인가요?"
        ),
        "answer": (
            "with open()을 사용하면 "
            "파일이 자동으로 압축됩니다."
        ),
        "label": False,
        "category": "file"
    },
    {
        "question": (
            "set은 언제 사용하면 좋은가요?"
        ),
        "answer": (
            "중복되지 않는 값의 집합을 "
            "다루거나 합집합, 교집합 같은 "
            "연산이 필요할 때 유용합니다."
        ),
        "label": True,
        "category": "python_basic"
    },
    {
        "question": (
            "set은 언제 사용하면 좋은가요?"
        ),
        "answer": (
            "set은 리스트의 별칭이라서 "
            "동작이 완전히 같습니다."
        ),
        "label": False,
        "category": "python_basic"
    }
]


def to_bco_example(
    row: dict
) -> dict:
    return {
        "prompt": [
            {
                "role": "system",
                "content": (
                    SYSTEM_MESSAGE
                )
            },
            {
                "role": "user",
                "content": (
                    row["question"]
                )
            }
        ],

        "completion": [
            {
                "role": "assistant",
                "content": (
                    row["answer"]
                )
            }
        ],

        "label": bool(
            row["label"]
        ),

        "category": (
            row["category"]
        )
    }


def print_distribution(
    rows
):
    label_counts = Counter(
        row["label"]
        for row in rows
    )

    category_counts = defaultdict(
        Counter
    )

    for row in rows:
        category_counts[
            row["category"]
        ][
            row["label"]
        ] += 1

    print(
        "\n[전체 Label]"
    )

    print(
        label_counts
    )

    print(
        "\n[Category별 Label]"
    )

    for category, counts in (
        category_counts.items()
    ):
        print(
            category,
            counts
        )


def stratified_split(
    examples: list[dict],
    test_ratio: float = 0.25
):
    rng = random.Random(
        SEED
    )

    positive = [
        row
        for row in examples
        if row["label"]
    ]

    negative = [
        row
        for row in examples
        if not row["label"]
    ]

    rng.shuffle(
        positive
    )

    rng.shuffle(
        negative
    )

    positive_test_size = max(
        1,
        round(
            len(positive)
            * test_ratio
        )
    )

    negative_test_size = max(
        1,
        round(
            len(negative)
            * test_ratio
        )
    )

    validation_rows = (
        positive[
            :positive_test_size
        ]
        +
        negative[
            :negative_test_size
        ]
    )

    train_rows = (
        positive[
            positive_test_size:
        ]
        +
        negative[
            negative_test_size:
        ]
    )

    rng.shuffle(
        train_rows
    )

    rng.shuffle(
        validation_rows
    )

    return (
        Dataset.from_list(
            train_rows
        ),
        Dataset.from_list(
            validation_rows
        )
    )


def select_dtype():
    if not torch.cuda.is_available():
        return torch.float32

    if torch.cuda.is_bf16_supported():
        return torch.bfloat16

    return torch.float16


def main():
    set_seed(
        SEED
    )

    OUTPUT_DIR.mkdir(
        parents=True,
        exist_ok=True
    )

    MODEL_DIR.mkdir(
        parents=True,
        exist_ok=True
    )

    print_distribution(
        RAW_FEEDBACK
    )

    examples = [
        to_bco_example(row)
        for row in RAW_FEEDBACK
    ]

    (
        train_dataset,
        validation_dataset
    ) = stratified_split(
        examples
    )

    print(
        "\nTrain:",
        len(train_dataset)
    )

    print(
        "Validation:",
        len(validation_dataset)
    )

    tokenizer = (
        AutoTokenizer
        .from_pretrained(
            MODEL_ID
        )
    )

    if tokenizer.pad_token is None:
        tokenizer.pad_token = (
            tokenizer.eos_token
        )

    model_dtype = (
        select_dtype()
    )

    print(
        "\n[Policy Model 로딩]"
    )

    policy_model = (
        AutoModelForCausalLM
        .from_pretrained(
            MODEL_ID,
            dtype=model_dtype
        )
    )

    print(
        "[Reference Model 로딩]"
    )

    reference_model = (
        AutoModelForCausalLM
        .from_pretrained(
            MODEL_ID,
            dtype=model_dtype
        )
    )

    lora_config = LoraConfig(
        task_type=(
            TaskType.CAUSAL_LM
        ),

        r=16,

        lora_alpha=32,

        lora_dropout=0.05,

        target_modules=[
            "q_proj",
            "k_proj",
            "v_proj",
            "o_proj"
        ],

        bias="none"
    )

    training_args = BCOConfig(
        output_dir=str(
            OUTPUT_DIR
        ),

        learning_rate=5e-7,

        lr_scheduler_type=(
            "linear"
        ),

        warmup_ratio=0.1,

        per_device_train_batch_size=4,

        per_device_eval_batch_size=4,

        gradient_accumulation_steps=4,

        num_train_epochs=3,

        max_length=512,

        beta=0.1,

        eval_strategy="epoch",

        save_strategy="epoch",

        logging_strategy="steps",

        logging_steps=1,

        logging_first_step=True,

        load_best_model_at_end=True,

        metric_for_best_model=(
            "eval_loss"
        ),

        greater_is_better=False,

        save_total_limit=2,

        gradient_checkpointing=True,

        remove_unused_columns=False,

        report_to="none",

        seed=SEED,

        data_seed=SEED,

        run_name=(
            "python-tutor-bco"
        )
    )

    trainer = BCOTrainer(
        model=policy_model,

        ref_model=(
            reference_model
        ),

        args=training_args,

        train_dataset=(
            train_dataset
        ),

        eval_dataset=(
            validation_dataset
        ),

        processing_class=(
            tokenizer
        ),

        peft_config=(
            lora_config
        )
    )

    print(
        "\n[학습 가능한 파라미터]"
    )

    trainer.model.print_trainable_parameters()

    print(
        "\n[BCO 학습 시작]"
    )

    train_result = (
        trainer.train()
    )

    trainer.log_metrics(
        "train",
        train_result.metrics
    )

    trainer.save_metrics(
        "train",
        train_result.metrics
    )

    trainer.save_state()

    print(
        "\n[Validation 평가]"
    )

    validation_metrics = (
        trainer.evaluate()
    )

    trainer.log_metrics(
        "validation",
        validation_metrics
    )

    trainer.save_metrics(
        "validation",
        validation_metrics
    )

    print(
        "\n[모델 저장]"
    )

    trainer.save_model(
        str(
            MODEL_DIR
        )
    )

    tokenizer.save_pretrained(
        MODEL_DIR
    )

    print(
        "\n완료"
    )

    print(
        MODEL_DIR.resolve()
    )


if __name__ == "__main__":
    main()
이 Dataset은 겨우 몇 개의 Sample뿐이므로 실제 성능 향상 목적이 아니라 BCO Pipeline을 확인하기 위한 실습용입니다.
운영 수준의 Alignment Model을 평가하려면 훨씬 많은 데이터와 독립적인 Test Set이 필요합니다.
35. UDM을 실제로 연결하려면
앞의 예제는 Topic별 Positive와 Negative를 의도적으로 섞었기 때문에 UDM 없이 학습했습니다.
실제 데이터가:
좋아요

→ 글쓰기 Prompt 위주


싫어요

→ 코딩 Prompt 위주
라면 UDM을 검토할 수 있습니다.
현재 BCOTrainer는:
embedding_func와:
embedding_tokenizer를 받을 수 있습니다.
개념적인 구조:
trainer = BCOTrainer(
    model=policy_model,

    ref_model=reference_model,

    args=training_args,

    train_dataset=train_dataset,

    processing_class=tokenizer,

    embedding_func=(
        embedding_func
    ),

    embedding_tokenizer=(
        embedding_tokenizer
    )
)
Config에는 UDM 관련 옵션이 있습니다.
training_args = BCOConfig(
    prompt_sample_size=512,

    min_density_ratio=0.5,

    max_density_ratio=10.0
)
현재 기본값은 `prompt_sample_size=1024`, 최소 Density Ratio `0.5`, 최대 `10.0`입니다.
36. Embedding 함수는 이렇게 생긴다
Embedding Model은 서비스 모델과 별개의 모델을 사용할 수 있습니다.
from functools import partial

import torch

from accelerate import Accelerator

from transformers import (
    AutoModel,
    AutoTokenizer
)


EMBED_MODEL_ID = (
    "nomic-ai/"
    "nomic-embed-text-v1.5"
)


embedding_model = (
    AutoModel
    .from_pretrained(
        EMBED_MODEL_ID
    )
)


embedding_tokenizer = (
    AutoTokenizer
    .from_pretrained(
        EMBED_MODEL_ID
    )
)
단순 Mean Pooling 예:
def embed_prompt(
    input_ids,
    attention_mask,
    model
):
    with torch.no_grad():
        outputs = model(
            input_ids=input_ids,
            attention_mask=(
                attention_mask
            )
        )

    hidden = (
        outputs
        .last_hidden_state
    )

    mask = (
        attention_mask
        .unsqueeze(-1)
    )

    summed = (
        hidden
        * mask
    ).sum(
        dim=1
    )

    count = (
        mask
        .sum(
            dim=1
        )
        .clamp(
            min=1
        )
    )

    return (
        summed
        / count
    )
준비:
accelerator = (
    Accelerator()
)


embedding_model = (
    accelerator
    .prepare_model(
        embedding_model
    )
)


embedding_func = partial(
    embed_prompt,
    model=embedding_model
)
실제 Embedding Model마다 권장 Pooling이나 Prompt Prefix가 다를 수 있으므로 해당 모델의 사용법에 맞춰 구현해야 합니다.
현재 TRL 공식 BCO Script 역시 별도의 Embedding Model과 `embedding_func`를 만들어 UDM에 전달하는 구조를 사용합니다.
37. UDM을 켜기 전에 더 쉬운 방법도 있다
개인적으로는 UDM부터 켜기 전에 Data Sampling을 먼저 살펴보겠습니다.
원본:
좋아요

글쓰기 900
코딩 100


싫어요

글쓰기 100
코딩 900
이라면 학습 Dataset을 일부 조정해:
좋아요

글쓰기 500
코딩 300


싫어요

글쓰기 300
코딩 500
처럼 Topic 편향을 줄일 수도 있습니다.
물론 데이터를 억지로 버리는 것이 항상 좋은 해결책은 아닙니다.
핵심은:
Label

과

Prompt Topic
사이의 상관관계를 먼저 발견하는 것입니다.
발견한 뒤:
Sampling

Weighting

UDM

추가 데이터 수집
중 어떤 방법이 적절할지 결정하면 됩니다.
38. BCO에서 QLoRA도 가능하다
현재 공식 BCO Script에는 QLoRA 실행 예제가 포함되어 있습니다. 4비트 로딩과 PEFT를 함께 사용하고 `all-linear` LoRA Target을 지정하는 형태입니다.
BCOTrainer 자체에는 일부 다른 Trainer처럼 `quantization_config` 인자를 직접 넣는 형태가 아닙니다.
따라서 Quantized Model을 먼저 불러옵니다.
import torch

from transformers import (
    AutoModelForCausalLM,
    BitsAndBytesConfig
)


compute_dtype = (
    torch.bfloat16
    if (
        torch.cuda.is_available()
        and torch.cuda.is_bf16_supported()
    )
    else torch.float16
)


quantization_config = (
    BitsAndBytesConfig(
        load_in_4bit=True,

        bnb_4bit_quant_type=(
            "nf4"
        ),

        bnb_4bit_use_double_quant=True,

        bnb_4bit_compute_dtype=(
            compute_dtype
        )
    )
)


policy_model = (
    AutoModelForCausalLM
    .from_pretrained(
        MODEL_ID,

        quantization_config=(
            quantization_config
        )
    )
)
그 다음 PEFT Config와 함께 BCOTrainer에 전달하는 식으로 구성할 수 있습니다.
처음 BCO를 공부한다면 Full Precision 작은 모델이나 LoRA부터 성공시키고 QLoRA로 넘어가는 편이 디버깅하기 쉽습니다.
39. Reference Log Probability를 미리 계산할 수도 있다
BCO는 Policy와 Reference Model을 비교해야 합니다.
그래서 학습 중 Reference Model도 Forward를 수행해야 합니다.
GPU 메모리가 부족하다면:
precompute_ref_log_probs=True를 검토할 수 있습니다.
이 옵션은 학습 전에 Reference Log Probability를 Dataset 전체에 미리 계산해 두고, Training 과정에서는 Reference Model을 계속 메모리에 유지하지 않아도 되도록 할 수 있습니다.
예:
training_args = BCOConfig(
    output_dir=(
        "outputs/bco"
    ),

    precompute_ref_log_probs=True
)
메모리는 절약할 수 있지만 사전 계산 시간이 추가됩니다.
40. BCO 학습 전후에는 무엇을 비교해야 할까?
Preference Training에서:
Train Loss 감소만으로 성공했다고 판단하면 위험합니다.
별도의 Test Prompt를 준비합니다.
예:
Python에서 얕은 복사와
깊은 복사의 차이는 무엇인가요?


asyncio.gather()는
언제 사용하나요?


FastAPI Dependency Injection을
간단히 설명해주세요.


Python GIL이 무엇인가요?


dict.get()과 [] 접근의
차이는 무엇인가요?
Base Model과 BCO Model의 답변을 생성한 뒤 이름을 숨깁니다.
답변 A

vs

답변 B
평가 기준:
정확성

질문 관련성

설명 충분성

불필요한 장황함

코드 실행 가능성

잘못된 단정

안전성
을 별도로 평가합니다.
41. “좋아요가 늘었다”와 “모델이 좋아졌다”는 다르다
서비스에서 특히 조심해야 하는 부분입니다.
BCO 모델을 배포한 후:
좋아요 비율

70%

→

82%
가 되었다고 하겠습니다.
반가운 숫자입니다.
하지만 이유를 확인해야 합니다.
예를 들어 모델이 모든 답변을:
물론입니다! 😊
좋은 질문입니다!
자세하게 설명드리겠습니다!
로 시작해서 사용자가 더 친근하게 느꼈을 수도 있습니다.
실제 정확성은 그대로일 수 있습니다.
더 나쁜 경우:
사용자가 듣고 싶은 답

→ 적극적으로 제공


불확실성 표현

→ 감소
해서 좋아요가 늘 수도 있습니다.
Alignment의 목표는:
클릭률 최대화와 반드시 같지 않습니다.
42. BCO에서 가장 조심해야 할 것은 Label Leakage다
아까 이야기한 Topic 편향도 Label Leakage의 한 형태로 볼 수 있습니다.
예를 들어:
좋아요 답변
좋은 질문입니다!
...
싫어요 답변
죄송하지만...
...
이라는 Pattern이 반복된다면 모델은 내용이 아니라 첫 문장으로 Label을 구분할 수도 있습니다.
또:
Positive Response

평균 1,500자


Negative Response

평균 200자
라면:
길면 Positive라는 Shortcut을 학습할 가능성도 있습니다.
그래서 학습 전 다음 통계를 보는 편이 좋습니다.
Positive / Negative 수

평균 Prompt 길이

평균 Completion 길이

Topic 분포

언어 분포

응답 형식

코드 블록 비율

거절 답변 비율
BCO에서는 분류 문제라는 관점이 강하기 때문에 이런 Feature Leakage를 찾는 습관이 특히 유용합니다.
43. BCO와 KTO 중 무엇을 고를까?
둘 다:
👍

👎
데이터를 사용할 수 있습니다.
그래서 실무에서는 선택이 애매할 수 있습니다.
저라면 다음 관점으로 비교하겠습니다.
KTO가 자연스러운 경우
인간의 Desirable / Undesirable Feedback을 Utility 관점으로 다루고 싶고 KTO의 간결한 Unpaired Preference 학습 방식을 사용하고 싶은 경우입니다.
BCO가 자연스러운 경우
좋아요와 싫어요 데이터를:
Positive

vs

Negative
라는 분류 문제로 명확하게 해석하고 싶거나, 특히 두 집단의 Prompt Distribution 차이를 UDM으로 보정하고 싶은 경우입니다.
44. DPO·KTO·BCO를 한 번에 비교하면
| 구분 | DPO | KTO | BCO |
|---|---|---|---|
| 데이터 | Chosen + Rejected | Completion + Label | Completion + Label |
| Pair 필요 | O | X | X |
| 좋아요·싫어요 활용 | 가공 필요 | 적합 | 적합 |
| 핵심 관점 | Pairwise Preference | Human Utility | Binary Classification |
| Reference Model | O | O | O |
| Implicit Reward | O | O | O |
| Topic Distribution 보정 | 핵심 기능 아님 | 핵심 기능 아님 | UDM |
| TRL 상태 | Stable | Stable | Experimental |
| 대표 Trainer | DPOTrainer | KTOTrainer | BCOTrainer |
BCO 논문은 Binary Classification Objective와 DPO의 이론적 연결을 제시하면서 Reward Shift와 UDM을 핵심 구성으로 제안합니다.
45. 실서비스 BCO Pipeline이라면 이렇게 구성하겠다
사용자 질문

↓

AI 답변

↓

👍 / 👎

↓

Raw Feedback DB

↓

개인정보 제거

↓

중복 / Spam 제거

↓

명확한 Feedback만 선택

↓

Topic 분류

↓

Label별 Topic 분포 분석

↓

Completion Length 분석

↓

Positive / Negative 균형 확인

↓

필요하면 UDM 적용

↓

Train / Validation / Test

↓

BCO Training

↓

Offline Human Evaluation

↓

Canary 배포

↓

실서비스 품질 비교
여기서 실제로 가장 많은 시간이 들어가는 구간은:
BCOTrainer보다:
Raw Feedback

↓

믿을 수 있는 Dataset
사이일 가능성이 높습니다.
46. 자주 발생할 수 있는 문제
BCOTrainer Import가 되지 않는다
잘못된 현재 Import:
from trl import BCOTrainerBCO는 현재 Experimental API입니다.
from trl.experimental.bco import (
    BCOConfig,
    BCOTrainer
)
를 사용합니다.
예전 강좌와 Import 경로가 다르다
Experimental API는 변경 가능성이 높습니다.
운영 프로젝트라면:
requirements.txt또는:
pyproject.toml에 버전을 고정합니다.
trl==1.10.0Dataset Column이 맞지 않는다
확인:
print(
    train_dataset.column_names
)
기본적으로:
prompt

completion

label
형태인지 확인합니다.
Label이 문자열이다
가능하면:
True
False
Boolean으로 정리합니다.
다음처럼 그대로 두지 않는 편이 좋습니다.
"LIKE"

"DISLIKE"
좋아요 Dataset에는 Python만 있고 싫어요에는 DevOps만 있다
BCO에서 특히 주의해야 하는 상황입니다.
먼저 Topic Distribution을 분석합니다.
필요하면:
추가 데이터 수집

Sampling

Weighting

UDM
을 검토합니다.
TRL 공식 BCO 문서가 UDM을 별도 기능으로 제공하는 이유가 바로 이런 Prompt Distribution 차이입니다.
UDM 관련 Package 오류
BCO UDM에는 scikit-learn과 joblib가 필요합니다.
설치:
python -m pip install --upgrade "trl[bco]"학습은 잘 되는데 어려운 질문을 회피하기 시작한다
상당히 중요한 신호입니다.
Dataset에서:
어려운 질문

→ Negative
상관관계가 지나치게 강했을 가능성이 있습니다.
Prompt Distribution을 다시 분석합니다.
답변이 점점 길어진다
Positive Completion이 Negative보다 평균적으로 훨씬 길지 않은지 확인합니다.
Positive 평균:

850 Token


Negative 평균:

170 Token
이라면 모델이:
길게 답하기

=

좋은 답
라는 Shortcut을 배울 수 있습니다.
반대로 답변이 너무 짧아진다
Negative Sample이 장황하고 Positive Sample이 짧다면 반대 현상이 발생할 수 있습니다.
내용 품질과 Length를 분리해서 분석하는 편이 좋습니다.
CUDA Out of Memory
BCO는 Reference Model이 필요하므로 일반 SFT보다 메모리 부담이 커질 수 있습니다.
우선:
LoRA

max_length 감소

Gradient Checkpointing

Reference Log Probability 사전 계산

QLoRA
를 검토합니다.
현재 BCOConfig에서는 Gradient Checkpointing이 기본 활성화되어 있으며 `precompute_ref_log_probs`도 제공합니다.
Beta를 크게 했더니 거의 변하지 않는다
Beta가 높을수록 Reference에서 이탈하기 어렵습니다.
다음 값을 비교해 볼 수 있습니다.
0.05

0.1

0.2
다만 Beta 하나만 보고 결정하지 말고 Validation 품질을 함께 봅니다.
Training Loss는 좋은데 실제 답변은 별 차이가 없다
가능합니다.
Tiny Dataset이거나 Signal이 약할 수 있습니다.
또:
Label Accuracy와:
Generation Quality는 완전히 같은 문제가 아닙니다.
반드시 실제 Generation을 비교합니다.
47. 연습 문제
문제 1
BCO의 전체 이름을 작성하세요.
Binary Classifier Optimization문제 2
다음 데이터를 BCO Dataset으로 변환하세요.
질문:

Python의 enumerate란?


답변:

반복할 때 인덱스와 값을
함께 얻을 수 있는 함수입니다.


Feedback:

👍
문제 3
Conversational Format으로 변경하세요.
문제 4
다음 Dataset의 문제점을 설명하세요.
Positive:

Python 기초 1,000개


Negative:

Kubernetes 오류 1,000개
문제 5
위 문제를 해결할 때 UDM이 어떤 역할을 할 수 있는지 설명하세요.
문제 6
다음 BCOConfig를 작성하세요.
Learning Rate:

5e-7


Beta:

0.1


Max Length:

512
문제 7
Qwen 모델에 LoRA를 적용하세요.
r:

16


alpha:

32
문제 8
Label별 평균 Completion Token 수를 계산하세요.
문제 9
Label별 Category 비율을 표로 출력하세요.
문제 10
Positive와 Negative의 Prompt Embedding 분포를 비교하세요.
문제 11
다음 Beta를 비교하세요.
0.05

0.1

0.2
문제 12
각 Beta에서 Base Model 대비 Win Rate를 기록하세요.
문제 13
`precompute_ref_log_probs=True`와 기본 설정의 GPU 메모리 사용량을 비교하세요.
문제 14
QLoRA BCO를 구성하세요.
문제 15
다음 Topic별 데이터에서 UDM 적용 전후 성능을 비교하세요.
Writing

Coding

Math

General QA
문제 16
Positive와 Negative의 평균 답변 길이를 동일한 범위로 맞춘 Dataset을 만들어 보세요.
문제 17
사람이 평가하는 Blind Test Set 100개를 구성하세요.
문제 18
DPO·KTO·BCO를 같은 Base Model과 같은 Feedback 원천 데이터로 학습해 결과를 비교하세요.
문제 19
다음 지표를 비교하세요.
사실 정확성

Helpfulness

응답 길이

Hallucination

거절 비율

Human Win Rate
문제 20
실제 Feedback Pipeline을 설계하세요.
Feedback DB

↓

Cleaning

↓

PII Removal

↓

Topic Analysis

↓

Label Distribution

↓

UDM

↓

BCO Training

↓

Offline Test

↓

Canary Deployment
48. 이번 편에서 꼭 기억할 것
BCO Dataset은 어렵지 않습니다.
{
    "prompt": "...",

    "completion": "...",

    "label": True
}
또는:
{
    "prompt": "...",

    "completion": "...",

    "label": False
}
현재 Import:
from trl.experimental.bco import (
    BCOConfig,
    BCOTrainer
)
기본 Config의 핵심:
training_args = BCOConfig(
    learning_rate=5e-7,

    beta=0.1,

    max_length=512
)
Trainer:
trainer = BCOTrainer(
    model=policy_model,

    ref_model=reference_model,

    args=training_args,

    train_dataset=train_dataset,

    processing_class=tokenizer,

    peft_config=lora_config
)
학습:
trainer.train()이 코드만 보면 BCO는 꽤 단순합니다.
하지만 이 글에서 더 중요하게 기억했으면 하는 부분은 따로 있습니다.
Positive Dataset과

Negative Dataset이

정말 같은 종류의 질문에서
나온 데이터인가?
입니다.
49. 마무리
BCO를 처음 봤을 때는 이름 그대로:
좋아요

vs

싫어요
를 분류하는 알고리즘 정도로 생각하기 쉽습니다.
틀린 설명은 아닙니다.
하지만 실제 Dataset까지 생각하고 나면 BCO가 던지는 질문은 조금 더 깊어집니다.
예를 들어 이런 Dataset이 있다고 해보겠습니다.
좋아요 10,000개

싫어요 10,000개
숫자만 보면 아주 균형 잡힌 Dataset입니다.
그런데 내용을 열어보니:
좋아요 10,000개

→ 거의 모두 쉬운 질문


싫어요 10,000개

→ 거의 모두 어려운 질문
이라면 이야기가 완전히 달라집니다.
개수는 균형입니다.
하지만 분포는 균형이 아닙니다.
개발자:

“좋은 답변과 나쁜 답변을
구별해줘.”


Dataset:

“참고로 쉬운 질문은 거의 좋아요,
어려운 질문은 거의 싫어요야.”


모델:

“그럼 질문 난이도만 보면
되겠네요.”


개발자:

“아니.”
머신러닝 모델은 우리가 마음속으로 생각한 규칙을 배우지 않습니다.
Dataset에서 가장 쉽게 발견할 수 있는 규칙을 배웁니다.
이 점 때문에 BCO의 UDM이 흥미롭습니다.
BCO는 단순히:
👍 = 1

👎 = 0
만 이야기하지 않습니다.
한 단계 더 들어가:
Positive와 Negative Feedback이 서로 다른 종류의 Prompt에서 발생한 것은 아닌가?
를 고민합니다.
실서비스 Feedback을 Fine-tuning에 활용할 때 상당히 현실적인 문제입니다.
KTO가:
이 답변을
사용자는 좋아했는가?
라는 질문에서 출발했다면,
BCO는 그 데이터를 보면서 이렇게 묻는 셈입니다.
“좋아한 답과 싫어한 답을
분류할 수 있을까?

그런데 잠깐.

혹시 답변이 아니라
질문의 종류를 분류하고 있는 건 아니지?”
저는 BCO를 공부할 때 바로 이 두 번째 질문이 가장 기억에 남습니다.
Binary Feedback 자체는 구하기 쉽습니다.
👍

👎
버튼 두 개면 됩니다.
하지만 좋은 Alignment Dataset을 만드는 일은 여전히 쉽지 않습니다.
Feedback 수집

↓

Label 정제

↓

Topic 분석

↓

Length Bias 확인

↓

Prompt Distribution 확인

↓

필요하면 UDM

↓

BCO Training

↓

독립 평가
이 과정을 거쳐야 합니다.
결국 이번 편에서도 Trainer보다 Dataset 이야기가 더 길어졌습니다.
Preference Optimization을 계속 공부하다 보면 이것이 이상한 일이 아니라는 것을 알게 됩니다.
알고리즘이 아무리 좋아도:
무엇을 좋은 답이라고 정의했는가?가 틀리면 모델은 그 잘못된 정의를 열심히 배웁니다.
BCOTrainer는 좋아요와 싫어요를 학습할 수 있습니다.
하지만 어떤 좋아요와 어떤 싫어요를 믿을 것인지 결정하는 일은 여전히 사람의 몫입니다.
다음 편 예고
[Python 완전정복 시리즈 #47] ORPOTrainer 완벽 이해하기 | Reference Model 없이 SFT와 선호도 학습을 한 번에 처리하는 방법
지금까지 DPO, KTO, BCO를 살펴보면서 계속 등장한 모델이 하나 있습니다.
Reference ModelPolicy:
“저는 학습하겠습니다.”Reference:
“저는 원래 네가 어땠는지
기억하고 있겠습니다.”
그런데 대형 LLM에서 Reference Model을 함께 유지하는 것은 꽤 부담스럽습니다.
그래서 다음에는 이런 질문에서 출발합니다.
Reference Model 없이 Preference Optimization을 할 수 없을까?
ORPO는 SFT와 Preference Optimization을 하나의 목적함수 안에서 결합하는 접근입니다.
좋은 답변을 학습하는 SFT

+

좋은 답변과 나쁜 답변을
구별하는 Preference Loss

↓

한 번의 Training
즉 다음 편에서는:
SFT 먼저

↓

Preference Training 다시
가 아니라:
SFT + Preference

↓

동시에
처리하는 방법을 살펴보겠습니다.
Reference Model 한 명이 회의실에서 빠지게 됩니다.
Reference Model:

“이번 프로젝트에는
제가 필요 없다고요?”


ORPO:

“네.

회의실 GPU 좌석이
부족해서요.”
다음 편에서는 ORPOTrainer의 원리와 Odds Ratio, Reference-free Preference Optimization, LoRA·QLoRA 실습까지 연결해 보겠습니다.
#Python #파이썬 #Python강좌 #HuggingFace #TRL #BCO #BCOTrainer #BinaryClassifierOptimization #PreferenceLearning #UnpairedPreference #사용자피드백 #좋아요데이터 #싫어요데이터 #AI파인튜닝 #LLM #생성형AI #AI정렬 #Alignment #UDM #UnderlyingDistributionMatching #RewardShift #ImplicitReward #LoRA #QLoRA #PEFT #Transformers #DPO #KTO #ORPO #PostTraining #FineTuning #PyTorch #코딩공부 #프로그래밍