프로그래밍

언어, 프레임워크, 라이브러리 실전 가이드.

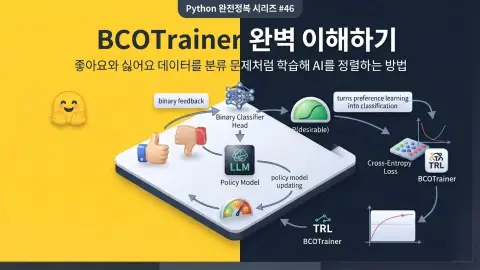
Python에서 Hugging Face TRL BCOTrainer로 좋아요와 싫어요 Binary Feedback을 학습해 AI를 정렬하는 방법을 설명하는 대표 이미지
프로그래밍 · Python

Python 완전정복 시리즈 46: BCOTrainer 완벽 이해하기

Python 완전정복 시리즈 46편입니다. Hugging Face TRL의 BCOTrainer를 이용해 좋아요와 싫어요 같은 Binary Feedback을 분류 문제처럼 활용해 언어 모델을 정렬하는 방법을 정리했습니다. BCO와 KTO·DPO의 차이, Implicit Reward, Reward Shift, UDM, Reference Model, Beta, LoRA·QLoRA, Label Leakage, 실서비스 Feedback Dataset 구축과 실전 학습 코드까지 다룹니다.

BeanCon2026-08-23
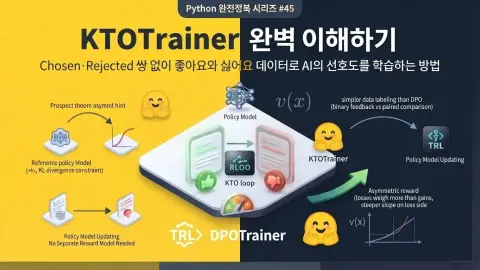
Python에서 Hugging Face TRL KTOTrainer로 좋아요와 싫어요 피드백을 이용해 AI 선호도를 학습하는 방법을 설명하는 대표 이미지
프로그래밍 · Python

Python 완전정복 시리즈 45: KTOTrainer 완벽 이해하기

Python 완전정복 시리즈 45편입니다. Hugging Face TRL의 KTOTrainer를 이용해 Chosen·Rejected 쌍 없이 Prompt, Completion, Label 기반 좋아요와 싫어요 데이터로 언어 모델의 선호도를 조정하는 방법을 정리했습니다. KTO와 DPO의 차이, Prospect Theory, Reference Model, Beta, 데이터 불균형, LoRA·QLoRA, 실서비스 로그 정제, KTOConfig, 실전 학습 코드와 운영 파이프라인까지 다룹니다.

BeanCon2026-08-20
Python에서 Hugging Face TRL RLOOTrainer로 Leave-One-Out Reward Baseline을 이용해 AI를 강화학습하는 방법을 설명하는 대표 이미지
프로그래밍 · Python

Python 완전정복 시리즈 44: RLOOTrainer 완벽 이해하기

Python 완전정복 시리즈 44편입니다. Hugging Face TRL의 RLOOTrainer로 Value Model 없이 자기 자신을 제외한 평균 Reward를 Baseline으로 사용해 생성형 AI를 강화학습하는 방법을 정리했습니다. RLOO와 REINFORCE, PPO·GRPO와의 차이, Leave-One-Out Baseline, Advantage 계산, num_generations, Reward Function, Accuracy Reward, Format Reward, 여러 Reward 조합, KL Penalty, Reference Model, Importance Sampling Ratio, Policy Clipping, RLOOConfig, LoRA·QLoRA, vLLM 가속, 실전 수학 프로젝트, Reward Hacking과 오류 해결까지 다룹니다.

BeanCon2026-08-18
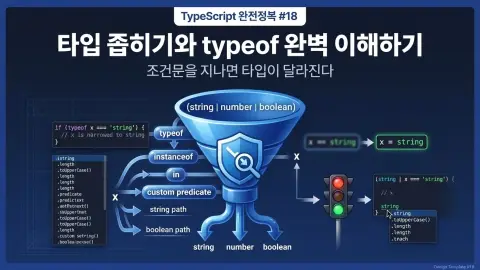
TypeScript 유틸리티 타입으로 기존 타입을 변환하고 재사용하는 방법을 설명하는 대표 이미지
프로그래밍 · TypeScript

TypeScript 완전정복 17화: TypeScript 유틸리티 타입 완벽 이해하기

TypeScript 완전정복 17화입니다. TypeScript가 기본 제공하는 유틸리티 타입으로 기존 타입을 다시 작성하지 않고 변환하고 재사용하는 방법을 정리했습니다. Partial, Required, Readonly, Pick, Omit, Record, Exclude, Extract, NonNullable, ReturnType, Parameters, ConstructorParameters, InstanceType, Awaited, Uppercase, Lowercase, Capitalize, Uncapitalize, 유틸리티 타입 조합, DTO 설계, API 공개 응답 타입, 함수 래퍼, 비동기 함수 결과 타입 추출과 실무 실수까지 다룹니다.

BeanCon2026-08-17
Python에서 Hugging Face TRL GRPOTrainer로 여러 답변의 상대 보상을 비교해 AI를 강화학습하는 방법을 설명하는 대표 이미지
프로그래밍 · Python

Python 완전정복 시리즈 43: GRPOTrainer 완벽 이해하기

Python 완전정복 시리즈 43편입니다. Hugging Face TRL의 GRPOTrainer로 Value Model 없이 여러 답변을 비교해 추론형 AI를 강화학습하는 방법을 정리했습니다. GRPO와 PPO의 차이, Group Sampling, Reward Function, Group Mean, Group Standard Deviation, Relative Advantage, Reward Zero Std, Outcome Reward, Accuracy Reward, Format Reward, 여러 Reward Function 조합, Reward Weight, KL Penalty, Policy Ratio와 Clipping, DAPO Loss, Dr. GRPO, GRPOConfig, LoRA·QLoRA, vLLM 생성 가속, 수학 추론 프로젝트, Reward Hacking과 오류 해결까지 다룹니다.

BeanCon2026-08-17
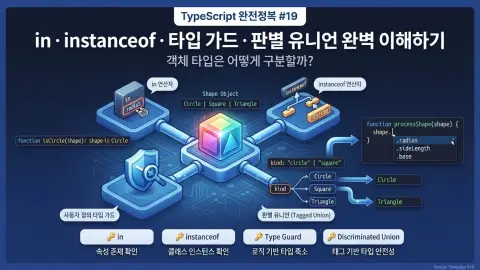
TypeScript 인덱스드 액세스 타입과 매핑된 타입으로 객체 타입을 변환하는 방법을 설명하는 대표 이미지
프로그래밍 · TypeScript

TypeScript 완전정복 16화: 인덱스드 액세스 타입과 매핑된 타입

TypeScript 완전정복 16화입니다. 인덱스드 액세스 타입과 매핑된 타입으로 객체 타입에서 원하는 값 타입을 꺼내고 새로운 타입으로 재조립하는 방법을 정리했습니다. T[K], T[keyof T], 선택적 속성 타입 추출, 중첩 객체 타입, 배열 요소 타입, 튜플 위치 타입, Partial·Readonly·Required의 원리, 매핑 수정자, 값 타입 일괄 변환, 필드별 오류·로딩 상태, 키 재매핑 as, Capitalize, Getter·Setter·이벤트 타입 생성, Pick·Omit·Record와 유틸리티 타입 원리까지 다룹니다.

BeanCon2026-08-15