목차
메타 설명
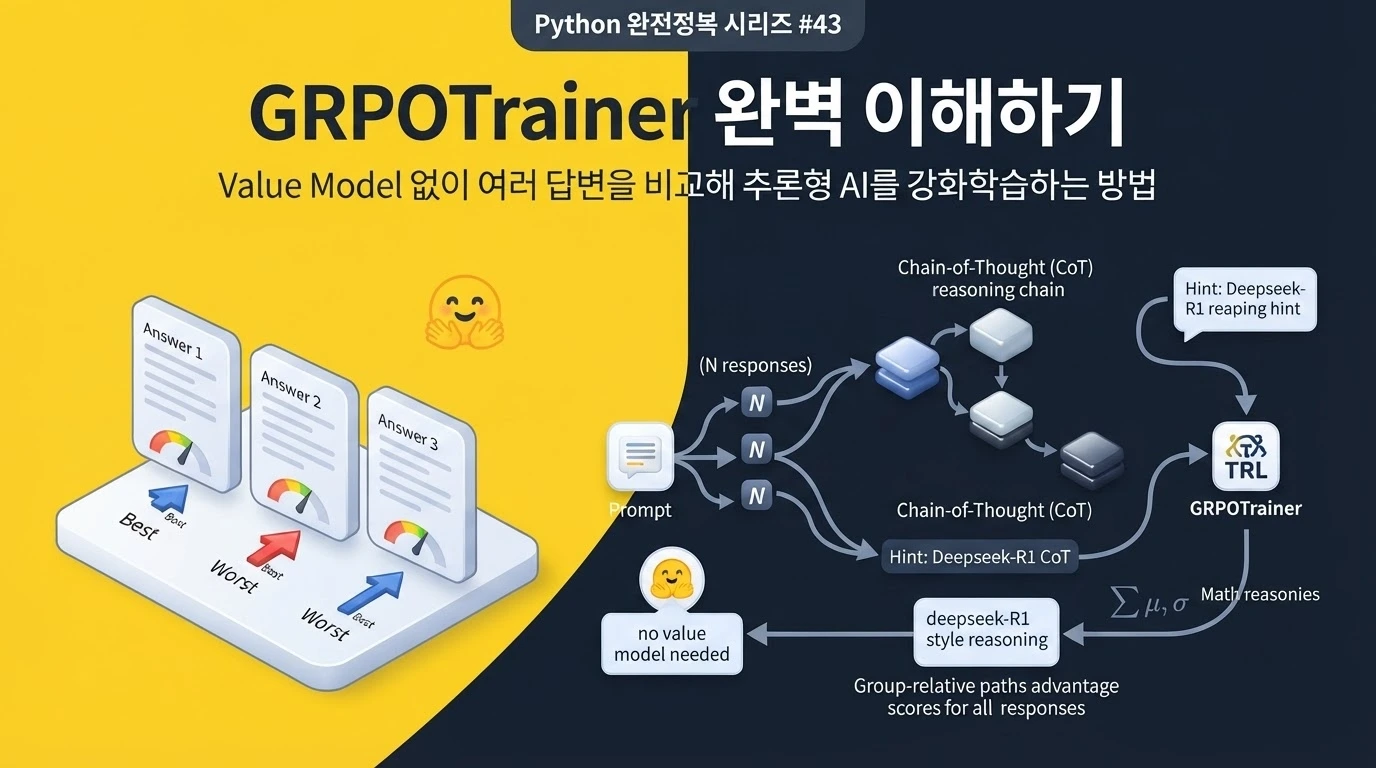
PPO의 Value Model 없이도 생성형 AI를 강화학습할 수 있을까요? Hugging Face TRL의 GRPOTrainer를 이용해 하나의 질문에서 여러 답변을 생성하고, Reward를 그룹 내에서 상대 비교해 Advantage를 계산하는 GRPO의 원리부터 Reward Function, Accuracy Reward, Format Reward, LoRA·QLoRA, DAPO·Dr.GRPO, vLLM 가속과 실전 추론 모델 학습까지 알아봅니다.
지난 시간에는 `PPOTrainer`를 이용해 Reward Model의 점수를 바탕으로 생성 모델을 강화학습하는 방법을 알아보았습니다.
PPO의 등장인물은 꽤 많았습니다.
Policy Model

Reference Model

Reward Model

Value Model
여기에:
Reward

KL Penalty

Return

Advantage

GAE

Policy Ratio

PPO Clipping
까지 등장했습니다.
처음 강화학습을 접한 개발자의 심정을 표현하면 대략 이렇습니다.
개발자:

“AI 하나를 학습하는 거죠?”


PPO:

“네.”


개발자:

“그런데 왜 모델이 네 개죠?”


PPO:

“강화학습이니까요.”


GPU:

“저는 퇴근하겠습니다.”
특히 PPO에는 Value Model이 필요했습니다.
Value Model은 현재 상태에서 앞으로 받을 Reward를 예상하고, 그 값을 이용해 Advantage를 계산합니다.
그런데 한 가지 재미있는 아이디어가 있습니다.
같은 질문에

답변을 하나만 만들지 말고

여러 개를 만들어 보면 어떨까?
예를 들어:
질문:

12 × 7은?
모델이 답변을 4개 생성합니다.
답변 A:
84

답변 B:
82

답변 C:
84

답변 D:
94
Reward:
A → 1

B → 0

C → 1

D → 0
그러면 같은 질문에서 어떤 답변이 상대적으로 좋은지 바로 알 수 있습니다.
그룹 평균 Reward:

0.5
따라서:
A:

평균보다 좋음
→ 강화


B:

평균보다 나쁨
→ 억제


C:

평균보다 좋음
→ 강화


D:

평균보다 나쁨
→ 억제
굳이 Value Model에게 이렇게 물어볼 필요가 없습니다.
“현재 상태에서
앞으로 받을 Reward가
얼마 정도일까요?”
같은 문제를 푼 친구들의 성적을 서로 비교하면 됩니다.
이 아이디어가 바로 GRPO입니다.
GRPO는 DeepSeekMath 논문에서 PPO의 Critic, 즉 Value Model을 제거하고 같은 Prompt에서 생성된 여러 답변의 Reward를 그룹 단위로 비교해 Baseline을 만드는 방식으로 제안되었습니다. 이를 통해 PPO보다 학습 자원을 줄이면서 수학적 추론 능력을 강화하는 것을 목표로 했습니다.
PPO:

“Value Model 선생님,
이번 답변은 예상보다 좋았나요?”


GRPO:

“친구들 점수표 가져와 보세요.

서로 비교하면 됩니다.”
오늘은 Group Relative Policy Optimization, GRPO의 세계로 들어가겠습니다. 🧠🏆🤖
1. GRPO란?
GRPO는 다음 표현의 약자입니다.
Group Relative Policy Optimization한국어로 풀어보면:
그룹 상대 정책 최적화정도입니다.
DeepSeekMath 연구에서 처음 제안되었으며, PPO에서 사용하던 Critic Model을 제거하고 같은 질문에 생성된 여러 Output의 Reward를 비교해 Advantage를 추정하는 것이 핵심입니다.
전체 구조는 다음과 같습니다.
Prompt

↓

Policy Model

↓

여러 Completion 생성

├─ Completion A
├─ Completion B
├─ Completion C
└─ Completion D

↓

각 Completion Reward 계산

↓

같은 그룹 안에서 상대 비교

↓

Advantage 계산

↓

Policy 업데이트
현재 Hugging Face TRL의 `GRPOTrainer`도 GRPO를 Online Learning 방식으로 구현하고 있으며, 학습 중 현재 Policy가 직접 여러 Completion을 생성하고 그 결과의 Reward로 반복 학습합니다.
2. 왜 GRPO가 등장했을까?
PPO는 강력하지만 LLM 강화학습에서 구조가 무겁습니다.
지난 편의 PPO 구조를 떠올려 보겠습니다.
Policy Model

Reference Model

Reward Model

Value Model
특히 Value Model은 Policy Model과 비슷한 규모의 Transformer Backbone을 가질 수 있습니다.
7B 모델을 사용한다면:
Policy:
7B

Reference:
7B

Reward:
7B급 가능

Value:
7B급 가능
메모리 최적화를 하더라도 부담이 큽니다.
DeepSeekMath 논문은 PPO의 Critic을 제거하고 그룹 점수를 Baseline으로 이용하는 GRPO를 제안해 PPO보다 학습 자원 사용을 줄였습니다.
GRPO:

“Value Model을 없애겠습니다.”


GPU:

“드디어 제 이야기를
들어주는 사람이 있군요.”
3. PPO와 GRPO의 핵심 차이
PPO
Advantage를 계산하기 위해 Value Model을 사용합니다.
현재 상태

↓

Value Model

↓

예상 Return


실제 Return

-

예상 Return

↓

Advantage
GRPO
같은 Prompt에서 여러 답변을 생성합니다.
Prompt

↓

A
B
C
D
각각 Reward를 계산합니다.
A → 1.0
B → 0.2
C → 0.8
D → -0.3
그리고 그룹 평균과 비교합니다.
A:

평균보다 좋음


D:

평균보다 나쁨
이를 Advantage로 사용합니다.
현재 TRL 공식 문서도 각 Prompt마다 `G`개의 Completion을 생성하고, 같은 그룹 내 Reward 평균과 표준편차를 이용해 상대 Advantage를 구성한다고 설명합니다.
4. Value Model이 사라진다
PPO:
Policy

+

Value Model
GRPO:
Policy

+

Group Reward Statistics
즉:
Value Model이 하던
Baseline 추정 역할 일부를

같은 Prompt의
여러 Completion Reward가 대신한다.
이것이 GRPO의 가장 중요한 특징입니다.
PPO:

“분석가를 한 명 고용하겠습니다.”


GRPO:

“시험 본 학생들의 평균 점수만
계산하면 되지 않을까요?”
5. Group이라는 이름의 의미
GRPO의 `Group`은 다음 그룹입니다.
하나의 Prompt

+

그 Prompt에서 생성된
여러 Completion
예:
Prompt 1:

15 + 27은?


Group:

Completion 1
Completion 2
Completion 3
Completion 4
또 다른 Prompt:
Prompt 2:

8 × 9는?


별도의 Group:

Completion 1
Completion 2
Completion 3
Completion 4
Reward는 기본적으로 같은 문제에서 생성된 Completion끼리 상대 비교합니다.
6. GRPO의 전체 학습 흐름
GRPO는 크게 네 단계로 이해하면 쉽습니다.
① Completion 생성

② Reward 계산

③ Group Relative Advantage 계산

④ Policy 업데이트
현재 TRL 공식 설명 역시 GRPO를 Completion Generation, Advantage 계산, 필요할 경우 KL 추정, Loss 계산의 흐름으로 설명합니다.
좀 더 자세히 보면:
Prompt

↓

여러 Completion Sampling

↓

Reward Function

↓

Reward Group 생성

↓

Group 평균

↓

Group 표준편차

↓

Advantage

↓

Policy Ratio

↓

Clipping

↓

Loss

↓

Gradient Update
7. Prompt 하나에서 여러 답변 생성
GRPO의 첫 번째 핵심입니다.
질문:

17 × 6은?
한 답변만 생성하지 않습니다.
답변 1:
102

답변 2:
112

답변 3:
102

답변 4:
92
TRL에서는 이 개수를 `num_generations`로 설정합니다.
현재 기본값은:
num_generations=8입니다.
즉 기본 설정이라면 Prompt 하나마다 최대 8개의 후보 Completion을 생성합니다.
8. Reward 계산
각 Completion을 Reward Function으로 평가합니다.
정답:

102
Reward:
Completion 1:
102
→ 1

Completion 2:
112
→ 0

Completion 3:
102
→ 1

Completion 4:
92
→ 0
Reward는 반드시 학습된 Reward Model일 필요가 없습니다.
현재 GRPOTrainer는 다음을 Reward Source로 사용할 수 있습니다.
Custom Python Function

Sequence Classification Reward Model

Hub Reward Model ID

여러 Reward 함수의 조합
또한 Custom Reward Function은 Prompt, Completion 및 Dataset의 추가 열을 전달받아 점수를 계산할 수 있습니다.
9. Group Mean
Reward가 다음과 같다고 하겠습니다.
[1, 0, 1, 0]평균:
0.5각 답변을 절대적인 0과 1로만 판단하지 않고 그룹 평균과 비교합니다.
1:

그룹 평균보다 좋음


0:

그룹 평균보다 나쁨
이것이 `Relative`의 의미입니다.
10. Group Standard Deviation
현재 TRL의 기본 Group Reward Scaling에서는 평균뿐 아니라 표준편차도 사용합니다.
기본 Advantage는 개념적으로:
Reward - Group Mean

───────────────

Group Std
형태입니다.
왜 표준편차로 나눌까요?
Reward Scale이 다른 문제들을 어느 정도 정규화할 수 있기 때문입니다.
문제 A Reward:

0
0
1
1


문제 B Reward:

20
40
80
100
Scale이 크게 다르더라도 상대적인 차이를 비교하기 쉬워집니다.
다만 이 표준편차 Scaling이 문제 난이도에 따른 편향을 유발할 수 있다는 후속 연구가 있어 현재 TRL은 `scale_rewards=False`와 `"batch"` 같은 대안도 제공합니다.
11. Relative Advantage
현재 기본적인 GRPO Advantage는 다음 아이디어입니다.
Advantage

=

현재 Completion Reward

-

같은 그룹 평균 Reward

───────────────

그룹 Reward 표준편차
TRL 공식 문서의 기본 설명도 이 Group-relative 정규화식을 사용합니다.
즉:
평균보다 좋은 답변

→ Advantage > 0


평균과 비슷한 답변

→ Advantage ≈ 0


평균보다 나쁜 답변

→ Advantage < 0
12. 실제 숫자로 Advantage 계산
4개 답변 Reward가 다음과 같다고 하겠습니다.
A:
10

B:
8

C:
4

D:
2
평균:
6단순하게 표준편차를 3이라고 가정하면:
A:

(10 - 6) / 3
= +1.33


B:

(8 - 6) / 3
= +0.67


C:

(4 - 6) / 3
= -0.67


D:

(2 - 6) / 3
= -1.33
따라서:
A:
강하게 강화

B:
약하게 강화

C:
약하게 억제

D:
강하게 억제
같은 Reward 8이라도 다른 문제의 그룹에서는 Advantage가 달라질 수 있습니다.
이것이 절대 Reward보다 그룹 내 상대 위치를 중요하게 보는 방식입니다.
13. 좋은 답변과 나쁜 답변이 강화되는 과정
모델이 다음 답변을 만들었다고 하겠습니다.
Prompt:

25 × 4는?


Completion A:
100


Completion B:
20 × 4 = 80이므로 80입니다.


Completion C:
100입니다.


Completion D:
104입니다.
Reward:
A:
1

B:
0

C:
1

D:
0
GRPO는:
A와 C의 생성 확률

→ 높이는 방향


B와 D의 생성 확률

→ 낮추는 방향
으로 Policy를 수정합니다.
이 과정을 다양한 문제에서 반복하면 모델은 Reward를 잘 받는 문제 해결 패턴을 더 자주 선택하게 됩니다.
14. 모든 Reward가 같으면 어떻게 될까?
여기 GRPO의 중요한 특성이 있습니다.
모델이 생성한 답변이 모두 틀렸다고 하겠습니다.
Reward:

0
0
0
0
평균:
0서로 차이가 없습니다.
반대로 모든 답변이 맞아도:
1
1
1
1
역시 서로 차이가 없습니다.
이 경우 그룹 내 상대 비교에서 학습 신호가 거의 사라집니다.
GRPO:

“누가 잘했나요?”


Reward:

“전부 똑같습니다.”


GRPO:

“그럼 누구를 칭찬해야 하죠?”
15. Reward Zero Std 문제
현재 TRL은 이 문제를 확인하기 위해 다음 Metric을 기록합니다.
frac_reward_zero_std이는 한 Prompt의 여러 Completion이 모두 동일한 Reward를 받아 Reward 표준편차가 0인 그룹 비율을 나타냅니다.
예:
frac_reward_zero_std:

0.75
라면 많은 Prompt에서 Completion들이 서로 구분되지 않고 있을 가능성이 있습니다.
원인은 여러 가지입니다.
문제가 너무 쉬움

→ 모두 정답


문제가 너무 어려움

→ 모두 오답


Reward Function이 너무 거침

→ 전부 0 또는 전부 1


Temperature가 너무 낮음

→ 거의 같은 답변만 생성
GRPO 학습에서는 매우 중요한 진단 지표입니다.
16. GRPO와 추론 모델의 관계
GRPO는 DeepSeekMath에서 수학 추론 강화를 위해 제안되었고 이후 DeepSeek-R1 계열의 대규모 Reinforcement Learning 접근으로 널리 알려졌습니다. DeepSeek-R1 연구는 RL을 통해 수학·코딩·논리와 같은 추론 능력을 강화하는 과정을 설명합니다.
왜 추론 문제와 GRPO가 잘 맞을까요?
수학과 코딩에는 비교적 명확한 Verifier를 만들 수 있기 때문입니다.
수학:

최종 정답 비교


코딩:

Unit Test


퍼즐:

정답 규칙 검사


형식:

정규식 검사
즉 사람이 모든 답변을 일일이 평가하지 않아도 자동 Reward Function을 만들 수 있습니다.
17. Outcome Reward란?
Outcome Reward는 최종 결과를 기준으로 Reward를 부여합니다.
문제:

15 × 8은?


추론 과정:

어떤 방식이든 가능


최종 답:

120


Reward:

1
중간 추론을 직접 채점하지 않고 최종 Outcome을 평가합니다.
정답이면:

1


오답이면:

0
GRPOTrainer에서는 Custom Reward Function을 작성하거나 Sequence Classification Reward Model을 연결하여 Outcome을 평가할 수 있습니다.
18. Accuracy Reward
현재 TRL에는 수학 문제와 같은 Verifiable Task에 사용할 수 있는 `accuracy_reward`가 제공됩니다.
공식 GRPO Quick Start도 다음 구조를 사용합니다.
from datasets import load_dataset
from trl import GRPOTrainer
from trl.rewards import accuracy_reward


dataset = load_dataset(
    "trl-lib/DeepMath-103K",
    split="train"
)


trainer = GRPOTrainer(
    model=(
        "Qwen/"
        "Qwen2.5-0.5B-Instruct"
    ),
    reward_funcs=accuracy_reward,
    train_dataset=dataset
)


trainer.train()
TRL 공식 예제는 Qwen2.5 0.5B Instruct와 DeepMath-103K Prompt를 이용해 GRPO 학습 구조를 보여줍니다.
19. Format Reward
정답만 맞으면 되는 것은 아닐 수 있습니다.
예를 들어 다음 형식을 요구한다고 하겠습니다.
<answer>84</answer>좋은 출력:
계산 결과는 다음과 같습니다.

<answer>84</answer>
형식 오류:
정답은 84입니다.정답은 맞지만 시스템에서 자동 Parsing하기 어렵습니다.
따라서 Format Reward를 추가할 수 있습니다.
현재 TRL 공식 문서도 정규식을 이용해 특정 `<think>...</think><answer>...</answer>` 형태를 검사하는 Custom Format Reward 예제를 제공합니다.
우리는 더 단순하게:
<answer>...</answer>만 사용하겠습니다.
20. 여러 Reward Function 조합
GRPOTrainer는 여러 Reward Function을 동시에 사용할 수 있습니다.
reward_funcs=[
    accuracy_reward_func,
    format_reward_func
]
현재 TRL은 각 Reward Function의 결과를 합산하며, `reward_weights`가 지정되면 가중합을 사용합니다.
예:
정답 Reward:

1.0


Format Reward:

0.2


Total Reward:

1.2
또 다른 답변:
정답 틀림:

0


Format 정확:

0.2


Total:

0.2
21. Reward Weight
Reward마다 중요도를 다르게 지정할 수 있습니다.
reward_weights=[
    1.0,
    0.2
]
첫 번째 Reward는 정확성:
Weight:

1.0
두 번째는 Format:
Weight:

0.2
현재 `reward_weights`는 Reward Function 개수와 동일한 길이를 가져야 하며, 지정하지 않으면 각 Reward에 기본 Weight 1.0이 적용됩니다.
정확성:

★★★★★


예쁜 출력:

★☆☆☆☆
이런 우선순위를 줄 수 있습니다.
22. Rule-based Reward의 장점
수학이나 코딩처럼 정답을 검증할 수 있다면 별도의 Reward Model이 필요하지 않을 수 있습니다.
수학:

정답 문자열 비교


코딩:

Unit Test 결과


JSON:

Parser 성공 여부


SQL:

실행 결과 비교


정규식:

Format 검사
GRPOTrainer는 Custom Python Reward Function을 직접 지원하며, Reward Function은 Prompt, Completion, Tokenized Completion과 Dataset의 추가 열을 전달받을 수 있습니다.
장점:
Reward Model 학습 불필요

명확한 평가 기준

Reward Hacking 원인 추적 쉬움

실행 결과로 검증 가능
다만 Rule 자체가 부정확하다면 역시 잘못된 행동을 강화하게 됩니다.
23. Reward Model도 사용할 수 있을까?
가능합니다.
GRPOTrainer의 `reward_funcs`에는 다음 종류를 전달할 수 있습니다.
Python Callable

Reward Model ID 문자열

Sequence Classification Model

여러 종류의 혼합
현재 Reward Model ID가 전달되면 Sequence Classification Model을 `num_labels=1` 형태로 로드해 Reward 계산에 사용합니다.
예:
trainer = GRPOTrainer(
    model=POLICY_MODEL_ID,

    reward_funcs=[
        REWARD_MODEL_ID,
        format_reward_func
    ],

    train_dataset=dataset
)
즉:
사람 선호도 평가

→ Reward Model


정답 검사

→ Rule-based Reward


형식 검사

→ Python Reward Function
을 조합할 수도 있습니다.
24. GRPO에서 KL Penalty
원래 GRPO는 Policy가 Reference Model에서 지나치게 멀어지는 것을 억제하기 위해 KL Divergence 항을 포함합니다.
개념:
Reward가 높아지는 방향

+

Reference에서 너무 멀어지지 않기
TRL에서는 다음 값으로 조절합니다.
beta=0.00125. 현재 TRL은 beta=0이 기본
여기서 최신 TRL의 중요한 변화가 있습니다.
2026년 현재 `GRPOConfig`의 `beta` 기본값은:
beta=0.0입니다.
즉 기본 설정에서는 KL Reference Model을 사용하지 않으며, Reference Model을 로드하지 않아 메모리와 연산을 줄입니다. 공식 문서는 최근 GRPO 계열 연구에서 KL 항을 제외하는 구성이 널리 사용된 점을 이 기본값의 배경으로 설명합니다.
PPO:

Policy
Reference
Reward
Value


현재 기본 GRPO 구성:

Policy
Reward Function
상당히 단순해집니다.
다만 Reference 제약이 필요한 실험이라면:
beta=0.001처럼 0보다 큰 값을 사용할 수 있습니다. DeepSeek-R1 관련 설정 사례로 TRL 문서는 0.001을 언급합니다.
26. Policy Ratio와 Clipping
GRPO도 Policy가 한 번에 너무 크게 변하는 것을 막기 위해 Clipping을 사용할 수 있습니다.
개념적으로:
현재 Policy 확률

─────────────

Old Policy 확률
의 Ratio를 계산합니다.
Ratio ≈ 1

→ 변화 작음


Ratio 매우 큼

→ 변화 과도
GRPO의 여러 번 업데이트를 위한 Objective는 PPO처럼 Ratio를 일정 범위로 Clip하는 구조를 사용합니다.
27. epsilon의 의미
현재 기본값:
epsilon=0.2입니다.
기본적인 대칭 Clip 범위는:
1 - 0.2

~

1 + 0.2
즉:
0.8 ~ 1.2입니다.
현재 TRL은 `epsilon_high`를 별도로 지정해 상단 Clip 범위를 비대칭으로 구성하는 기능도 제공합니다.
28. num_iterations
GRPO는 한 번 생성한 Completion 그룹으로 Policy를 여러 번 업데이트할 수 있습니다.
num_iterations=1현재 기본값은 1입니다.
값을 늘리면:
Generation 비용 절약 가능

하지만

같은 Rollout에 더 많이 학습
하게 됩니다.
너무 많이 반복하면 현재 Sample에 과적합하거나 On-policy 데이터에서 멀어질 수 있으므로 Ratio와 Clip 관련 Metric을 함께 봐야 합니다.
29. Reward Scaling
Reward가 다음처럼 매우 큰 범위를 가질 수 있습니다.
문제 A:

0
1


문제 B:

-100
+100
그대로 사용하면 문제 B가 Gradient를 훨씬 크게 지배할 수 있습니다.
따라서 GRPO에서는 Reward Scaling 전략이 중요합니다.
30. scale_rewards 옵션
현재 TRL의 `scale_rewards` 기본값은:
scale_rewards="group"입니다.
선택지는 다음과 같습니다.
group
scale_rewards="group"같은 Prompt에서 생성된 Completion들의 표준편차로 Scaling합니다.
현재 기본값입니다.
batch
scale_rewards="batch"평균은 그룹 단위로 사용하면서 Standard Deviation은 전체 Batch 기준으로 계산하는 전략을 사용할 수 있습니다.
none
scale_rewards=False또는:
scale_rewards="none"Standard Deviation Scaling을 사용하지 않습니다.
후속 연구는 Group Std Scaling이 문제 난이도에 따른 Bias를 만들 수 있다고 지적했으며, TRL은 이러한 실험을 위해 다양한 Scaling 방식을 제공합니다.
31. GRPO의 길이 편향 문제
강화학습에서는 답변 길이가 의도치 않게 Optimization에 영향을 줄 수 있습니다.
예를 들어 Original GRPO Loss는 Completion별 평균 Token Loss를 사용했는데, 후속 연구에서는 이 방식이 Response Length와 Advantage의 관계에서 Bias를 만들 수 있다고 지적했습니다.
쉽게 말하면:
좋은 답변:

짧을수록 유리


나쁜 답변:

길수록 특정 방향으로
Gradient 영향이 달라짐
같은 이상한 최적화 경향이 발생할 수 있습니다.
32. DAPO Loss
DAPO 계열 방식은 Long Chain-of-Thought 상황에서 Token-level Loss Normalization을 수정해 길이 Bias 문제를 줄이는 방향을 제안했습니다.
현재 TRL에서는:
loss_type="dapo"로 사용할 수 있습니다.
그리고 중요한 사실이 있습니다.
33. Dr. GRPO
후속 연구 `Understanding R1-Zero-Like Training`은 Original GRPO의 Reward Scaling과 Length Bias를 분석하고 `Dr. GRPO`를 제안했습니다.
TRL에서:
loss_type="dr_grpo"로 사용할 수 있습니다.
이 Loss는 Completion 길이 자체 대신 `max_completion_length`와 연결된 일정한 Normalization Constant를 사용해 Length Bias를 줄이도록 설계되었습니다.
34. 현재 GRPOTrainer의 기본 Loss
이 부분은 최신 버전에서 특히 중요합니다.
클래스 이름은:
GRPOTrainer이지만 2026년 8월 현재 `GRPOConfig`의 기본 `loss_type`은:
loss_type="dapo"입니다.
즉 최신 TRL에서 아무 설정 없이:
GRPOTrainer(...)를 사용한다고 해서 Original GRPO Loss가 그대로 사용되는 것은 아닙니다.
Original GRPO를 직접 사용하려면:
loss_type="grpo"를 지정할 수 있습니다.
하지만 현재 공식 문서는 Original `"grpo"` Loss를 Length Bias 때문에 권장하지 않으며 `"dapo"`가 기본입니다.
클래스 이름:

GRPOTrainer


기본 Loss:

DAPO


개발자:

“이름은 GRPO인데요?”


TRL:

“가족이 많이 늘었습니다.”
35. 현재 TRL 버전
2026년 8월 14일 기준 PyPI의 최신 TRL 안정 버전은:
1.10.0입니다.
2026년 8월 13일 공개되었으며 Python 3.10 이상을 요구합니다.
GRPOTrainer는 현재 TRL의 일반 Trainer API에서 사용할 수 있습니다.
from trl import (
    GRPOConfig,
    GRPOTrainer
)
PPO가 `trl.experimental.ppo`에 있는 것과 달리 GRPOTrainer는 현재 핵심 Trainer 목록에 포함되어 있습니다.
버전 확인:
python -m pip show trl또는:
import trl


print(
    trl.__version__
)
36. 개발 환경 설치
Windows
python -m venv venv
venv\Scripts\activate

python -m pip install --upgrade pip
python -m pip install "transformers[torch]" datasets accelerate peft trl
macOS·Linux
python3 -m venv venv
source venv/bin/activate

python -m pip install --upgrade pip
python -m pip install "transformers[torch]" datasets accelerate peft trl
TRL은 Transformers, Accelerate, PEFT와 통합되어 있으며 GRPOTrainer도 PEFT와 Quantization Configuration을 지원합니다.
설치 확인:
import torch
import transformers
import trl


print(
    f"TRL: {trl.__version__}"
)

print(
    f"Transformers: "
    f"{transformers.__version__}"
)

print(
    f"CUDA: "
    f"{torch.cuda.is_available()}"
)
37. GRPOTrainer 기본 사용법
현재 공식 Quick Start는 놀랄 만큼 간단합니다.
from datasets import load_dataset

from trl import GRPOTrainer

from trl.rewards import (
    accuracy_reward
)


dataset = load_dataset(
    "trl-lib/DeepMath-103K",
    split="train"
)


trainer = GRPOTrainer(
    model=(
        "Qwen/"
        "Qwen2.5-0.5B-Instruct"
    ),

    reward_funcs=accuracy_reward,

    train_dataset=dataset
)


trainer.train()
실행:
accelerate launch train_grpo.py하지만 학습 과정을 제대로 이해하려면 Reward Function과 Config를 직접 만들어보는 것이 좋습니다.
38. Dataset 형식
GRPO Dataset의 핵심 열은:
prompt입니다.
현재 GRPOTrainer는 Plain Text 기반 Standard Format과 역할 기반 Conversational Format을 모두 지원합니다. Reward Function에 추가 정보가 필요하면 Dataset의 다른 열도 함께 유지할 수 있습니다.
우리 프로젝트:
{
    "prompt": (
        "문제: 17 × 8의 값을 계산하세요. "
        "최종 답은 <answer>숫자</answer> "
        "형식으로 출력하세요."
    ),

    "ground_truth": "136"
}
`ground_truth`는 Trainer가 모델 입력에 직접 사용하는 열은 아니지만 Custom Reward Function에 전달할 수 있습니다.
39. Custom Reward Function
현재 Custom Reward Function은 최소한 Completion을 받아 각 Completion마다 하나의 Reward를 반환하면 됩니다.
간단한 예:
def length_reward(
    completions,
    **kwargs
):
    return [
        float(
            len(completion)
        )
        for completion
        in completions
    ]
TRL 공식 문서도 Token 수나 Character 수에 따라 Reward를 반환하는 간단한 예제를 제공합니다.
하지만 이런 Reward를 실제로 사용하면:
길수록 점수가 높다.라는 이상한 모델을 만들 수 있으므로 설명용 예제로만 보는 것이 좋습니다.
40. 정답 Reward 만들기
우리 프로젝트에서는 `<answer>` 안의 정답을 추출합니다.
import re


def extract_answer(
    text: str
) -> str | None:
    match = re.search(
        r"<answer>\s*(.*?)\s*</answer>",
        text,
        flags=re.DOTALL
    )

    if match is None:
        return None

    return (
        match
        .group(1)
        .strip()
    )
Reward:
def accuracy_reward_func(
    completions,
    ground_truth,
    **kwargs
):
    rewards = []

    for completion, answer in zip(
        completions,
        ground_truth
    ):
        predicted = extract_answer(
            completion
        )

        reward = (
            1.0
            if predicted == str(answer)
            else 0.0
        )

        rewards.append(
            reward
        )

    return rewards
Custom Reward Function에는 Dataset의 `ground_truth` 같은 추가 열이 Keyword Argument로 전달됩니다.
41. Format Reward 만들기
이번에는 정확한 `<answer>` Tag를 사용했는지 검사합니다.
def format_reward_func(
    completions,
    **kwargs
):
    pattern = re.compile(
        r".*<answer>\s*"
        r"[^<>]+"
        r"\s*</answer>\s*$",
        flags=re.DOTALL
    )

    return [
        1.0
        if pattern.fullmatch(
            completion.strip()
        )
        else 0.0

        for completion
        in completions
    ]
Reward 조합:
정답 정확:

1.0


Format 정확:

0.2
으로 만들겠습니다.
42. Reward 함수에 Dataset 열 전달하기
Dataset:
{
    "prompt": "...",
    "ground_truth": "136",
    "difficulty": "easy"
}
Reward Function:
def reward_func(
    completions,
    ground_truth,
    difficulty,
    **kwargs
):
    ...
처럼 사용할 수 있습니다.
현재 GRPOTrainer는 Prompt와 Completion뿐 아니라 Dataset의 추가 열도 Reward Function에 전달합니다. 따라서 Multi-task Reward나 Difficulty-aware Reward도 구현할 수 있습니다.
중요한 설정:
remove_unused_columns=False현재 GRPOConfig의 기본값도 `False`이며, 추가 Dataset 열을 Custom Reward Function에서 사용할 때 유지해야 합니다.
43. GRPOConfig 핵심 옵션
현재 주요 설정 예입니다.
from trl import GRPOConfig


training_args = GRPOConfig(
    output_dir=(
        "outputs/"
        "math-grpo"
    ),

    learning_rate=5e-6,

    per_device_train_batch_size=1,

    gradient_accumulation_steps=4,

    num_train_epochs=3,

    num_generations=4,

    max_completion_length=128,

    temperature=0.8,

    beta=0.0,

    epsilon=0.2,

    num_iterations=1,

    scale_rewards="group",

    loss_type="dapo",

    reward_weights=[
        1.0,
        0.2
    ],

    logging_steps=1,

    log_completions=True,

    num_completions_to_print=2,

    report_to="none",

    gradient_checkpointing=True
)
현재 GRPOConfig의 주요 기본값으로는 Learning Rate `1e-6`, `num_generations=8`, `max_completion_length=512`, `temperature=1.0`, `beta=0.0`, `epsilon=0.2`, `num_iterations=1`, `scale_rewards="group"`, `loss_type="dapo"` 등이 있습니다.
44. num_generations
num_generations=4하나의 Prompt마다 생성하는 Completion 수입니다.
Prompt

├─ 1번
├─ 2번
├─ 3번
└─ 4번
값이 크면:
그룹 내 비교 정보 증가

다양한 해법 탐색

Reward Ranking 안정성 개선 가능
하지만:
Generation 비용 증가

GPU 메모리 증가

학습 시간 증가
가 발생합니다.
현재 기본값은 8입니다.
45. Batch Size와 num_generations 관계
중요한 제약이 있습니다.
현재 TRL에서는:
num_processes

×

per_device_train_batch_size

×

gradient_accumulation_steps
으로 계산되는 Effective Batch Size가 `num_generations`로 나누어 떨어져야 합니다.
예:
GPU:

1


Batch:

1


Gradient Accumulation:

4


Effective:

4


num_generations:

4
정상입니다.
하지만:
Effective Batch:

4


num_generations:

3
이면 나누어 떨어지지 않습니다.
GRPOTrainer:

“한 조에 세 명씩 배치하라면서
학생이 네 명인데요?”
46. max_completion_length
max_completion_length=128현재 기본값은 512 Token입니다.
추론 문제가 길다면:
max_completion_length=1024이 필요할 수도 있습니다.
하지만 길이가 커질수록:
Generation 시간

KV Cache

Training Memory

전체 Token 비용
이 크게 증가합니다.
TRL은 Completion 길이와 잘림 비율도 Log Metric으로 제공합니다.
47. Temperature
temperature=0.8현재 GRPOConfig의 기본값은:
temperature=1.0입니다.
Temperature가 너무 낮으면:
8개 Completion 생성

↓

거의 모두 같은 답
이 될 수 있습니다.
그러면:
Reward Std ↓

Advantage Signal ↓
가 발생합니다.
너무 높으면:
다양성 ↑

엉뚱한 답변 ↑
이 됩니다.
GRPO는 그룹 내 다양성이 필요하기 때문에 Sampling 설정도 중요한 Hyperparameter입니다.
48. LoRA와 GRPO
현재 GRPOTrainer는 `peft_config`를 직접 지원합니다.
from peft import (
    LoraConfig,
    TaskType
)


lora_config = LoraConfig(
    task_type=(
        TaskType.CAUSAL_LM
    ),

    r=16,

    lora_alpha=32,

    lora_dropout=0.05,

    target_modules=[
        "q_proj",
        "k_proj",
        "v_proj",
        "o_proj"
    ],

    bias="none"
)
Trainer:
trainer = GRPOTrainer(
    model=MODEL_ID,

    args=training_args,

    reward_funcs=[
        accuracy_reward_func,
        format_reward_func
    ],

    train_dataset=dataset,

    peft_config=lora_config
)
Policy 전체가 아니라 LoRA Adapter를 강화학습할 수 있습니다.
TRL 프로젝트 자체도 PEFT와 LoRA·QLoRA 통합을 공식 지원합니다.
49. QLoRA와 GRPO
GRPOTrainer에는 현재 `quantization_config`와 `peft_config`가 모두 존재합니다. 모델 ID 문자열을 전달할 때 Quantization을 적용하고 PEFT Adapter를 결합해 QLoRA 형태로 학습할 수 있습니다.
예:
import torch

from transformers import (
    BitsAndBytesConfig
)


quantization_config = (
    BitsAndBytesConfig(
        load_in_4bit=True,

        bnb_4bit_quant_type=(
            "nf4"
        ),

        bnb_4bit_use_double_quant=(
            True
        ),

        bnb_4bit_compute_dtype=(
            torch.bfloat16
        )
    )
)
연결:
trainer = GRPOTrainer(
    model=MODEL_ID,

    args=training_args,

    reward_funcs=[
        accuracy_reward_func
    ],

    train_dataset=dataset,

    peft_config=lora_config,

    quantization_config=(
        quantization_config
    )
)
이미 Model Object를 직접 만들어 전달한 경우 Trainer의 `quantization_config`는 적용되지 않습니다.
50. vLLM으로 생성 가속
GRPO는 Online RL입니다.
즉 학습 중 계속:
생성

생성

생성

생성
을 해야 합니다.
Generation이 병목이 되기 쉽습니다.
TRL은 GRPO의 Generation을 가속하기 위해 vLLM 통합을 제공합니다.
설치:
python -m pip install "trl[vllm]"활성화:
training_args = GRPOConfig(
    use_vllm=True
)
현재 두 가지 Mode가 있습니다.
Colocate
vllm_mode="colocate"Training Model과 같은 GPU 자원을 공유합니다.
Server
vllm_mode="server"vLLM Server를 별도 Process와 GPU에 두고 HTTP로 Generation 요청을 전달합니다.
대규모 학습에서는 Generation 전용 GPU를 분리할 수도 있습니다.
51. GRPO 학습 로그 읽기
GRPO는 Training Loss 하나만 보면 안 됩니다.
현재 TRL은 매우 다양한 GRPO Metric을 기록합니다.
중요한 항목:
reward

reward_std

frac_reward_zero_std

rewards/<name>/mean

rewards/<name>/std

completions/mean_length

completions/clipped_ratio

kl

clip_ratio/region_mean

entropy

num_tokens

step_time
하나씩 보겠습니다.
52. Reward
reward여러 Reward Function을 가중합한 전체 평균 Reward입니다.
현재 TRL에서 `reward_weights`가 있으면 그 Weight가 반영됩니다.
예:
Step 1:

0.32


Step 100:

0.54


Step 500:

0.71
증가하면 Reward Function 관점의 성능이 향상되고 있다는 신호입니다.
하지만 Reward Hacking 여부를 함께 확인해야 합니다.
53. Reward Std
reward_std전체 Batch에서 합산 Reward의 표준편차입니다.
너무 낮다면:
모델이 거의 같은 답을 생성

또는

Reward Function이 답을 구분하지 못함
일 수 있습니다.
너무 높다면:
답변 품질 변동이 매우 큼일 수 있습니다.
54. frac_reward_zero_std
앞서 본 핵심 지표입니다.
frac_reward_zero_std같은 Prompt 그룹의 Reward가 모두 동일한 비율을 보여줍니다.
높은 값이 계속 유지된다면:
GRPO가 비교할 대상이 없다.는 뜻일 수 있습니다.
예를 들어:
0.90이라면 Prompt 대부분이:
모두 정답

또는

모두 오답
인 상황인지 확인해야 합니다.
55. Completion Length
TRL은 현재 다음 Length Metric을 기록합니다.
completions/mean_length

completions/min_length

completions/max_length

completions/mean_terminated_length

completions/clipped_ratio
왜 중요할까요?
Reward가 올라가면서:
평균 답변 길이:

80

→ 500
으로 폭증한다면 Reward Function이 긴 답변을 선호하는 것은 아닌지 확인해야 합니다.
반대로:
500

→ 20
으로 갑자기 줄면 모델이 지나치게 짧은 Shortcut을 발견했을 수도 있습니다.
56. KL과 Clip Ratio
`beta`가 0보다 클 경우:
klMetric을 확인할 수 있습니다.
현재 `beta=0.0`이 기본이라 기본 구성에서는 Reference Model과 KL Metric을 사용하지 않습니다.
Policy Clipping과 관련해서는:
clip_ratio/region_mean

clip_ratio/low_mean

clip_ratio/high_mean
같은 Metric을 사용할 수 있습니다.
Clip Ratio가 지나치게 높다면 Policy Update가 너무 큰지 확인합니다.
57. 실전 수학 추론 프로젝트
이제 직접 작은 GRPO 프로젝트를 만들어 보겠습니다.
목표:
간단한 산술 문제

↓

모델이 여러 답변 생성

↓

정답 Reward

+

Format Reward

↓

Group Relative 학습
실제 Reasoning Model을 만들기에는 데이터가 너무 작지만 GRPO의 전체 Pipeline을 이해하는 데 적합한 예제입니다.
다음 내용을 `train_grpo.py`로 저장합니다.
from pathlib import Path
import re

from datasets import Dataset

from peft import (
    LoraConfig,
    TaskType
)

from trl import (
    GRPOConfig,
    GRPOTrainer
)


MODEL_ID = (
    "Qwen/"
    "Qwen2.5-0.5B-Instruct"
)

OUTPUT_DIR = Path(
    "outputs/"
    "math-grpo"
)

SEED = 2026


TRAINING_DATA = [
    {
        "prompt": (
            "문제: 12 × 7의 값을 계산하세요. "
            "필요한 계산을 수행한 뒤 "
            "최종 답은 반드시 "
            "<answer>숫자</answer> "
            "형식으로 출력하세요."
        ),
        "ground_truth": "84"
    },
    {
        "prompt": (
            "문제: 25 + 38의 값을 계산하세요. "
            "최종 답은 반드시 "
            "<answer>숫자</answer> "
            "형식으로 출력하세요."
        ),
        "ground_truth": "63"
    },
    {
        "prompt": (
            "문제: 144 ÷ 12의 값을 계산하세요. "
            "최종 답은 반드시 "
            "<answer>숫자</answer> "
            "형식으로 출력하세요."
        ),
        "ground_truth": "12"
    },
    {
        "prompt": (
            "문제: 17 × 8의 값을 계산하세요. "
            "최종 답은 반드시 "
            "<answer>숫자</answer> "
            "형식으로 출력하세요."
        ),
        "ground_truth": "136"
    },
    {
        "prompt": (
            "문제: 93 - 47의 값을 계산하세요. "
            "최종 답은 반드시 "
            "<answer>숫자</answer> "
            "형식으로 출력하세요."
        ),
        "ground_truth": "46"
    },
    {
        "prompt": (
            "문제: 16 × 9의 값을 계산하세요. "
            "최종 답은 반드시 "
            "<answer>숫자</answer> "
            "형식으로 출력하세요."
        ),
        "ground_truth": "144"
    },
    {
        "prompt": (
            "문제: 225 ÷ 15의 값을 계산하세요. "
            "최종 답은 반드시 "
            "<answer>숫자</answer> "
            "형식으로 출력하세요."
        ),
        "ground_truth": "15"
    },
    {
        "prompt": (
            "문제: 128 + 79의 값을 계산하세요. "
            "최종 답은 반드시 "
            "<answer>숫자</answer> "
            "형식으로 출력하세요."
        ),
        "ground_truth": "207"
    },
    {
        "prompt": (
            "문제: 300 - 128의 값을 계산하세요. "
            "최종 답은 반드시 "
            "<answer>숫자</answer> "
            "형식으로 출력하세요."
        ),
        "ground_truth": "172"
    },
    {
        "prompt": (
            "문제: 19 × 11의 값을 계산하세요. "
            "최종 답은 반드시 "
            "<answer>숫자</answer> "
            "형식으로 출력하세요."
        ),
        "ground_truth": "209"
    },
    {
        "prompt": (
            "문제: 256 ÷ 16의 값을 계산하세요. "
            "최종 답은 반드시 "
            "<answer>숫자</answer> "
            "형식으로 출력하세요."
        ),
        "ground_truth": "16"
    },
    {
        "prompt": (
            "문제: 67 + 89의 값을 계산하세요. "
            "최종 답은 반드시 "
            "<answer>숫자</answer> "
            "형식으로 출력하세요."
        ),
        "ground_truth": "156"
    },
    {
        "prompt": (
            "문제: 13 × 14의 값을 계산하세요. "
            "최종 답은 반드시 "
            "<answer>숫자</answer> "
            "형식으로 출력하세요."
        ),
        "ground_truth": "182"
    },
    {
        "prompt": (
            "문제: 500 - 273의 값을 계산하세요. "
            "최종 답은 반드시 "
            "<answer>숫자</answer> "
            "형식으로 출력하세요."
        ),
        "ground_truth": "227"
    },
    {
        "prompt": (
            "문제: 18 × 12의 값을 계산하세요. "
            "최종 답은 반드시 "
            "<answer>숫자</answer> "
            "형식으로 출력하세요."
        ),
        "ground_truth": "216"
    },
    {
        "prompt": (
            "문제: 324 ÷ 18의 값을 계산하세요. "
            "최종 답은 반드시 "
            "<answer>숫자</answer> "
            "형식으로 출력하세요."
        ),
        "ground_truth": "18"
    },
    {
        "prompt": (
            "문제: 45 + 76 - 21의 값을 계산하세요. "
            "최종 답은 반드시 "
            "<answer>숫자</answer> "
            "형식으로 출력하세요."
        ),
        "ground_truth": "100"
    },
    {
        "prompt": (
            "문제: 8 × 7 + 4의 값을 계산하세요. "
            "최종 답은 반드시 "
            "<answer>숫자</answer> "
            "형식으로 출력하세요."
        ),
        "ground_truth": "60"
    },
    {
        "prompt": (
            "문제: (15 + 5) × 3의 값을 계산하세요. "
            "최종 답은 반드시 "
            "<answer>숫자</answer> "
            "형식으로 출력하세요."
        ),
        "ground_truth": "60"
    },
    {
        "prompt": (
            "문제: 100 ÷ 4 + 17의 값을 계산하세요. "
            "최종 답은 반드시 "
            "<answer>숫자</answer> "
            "형식으로 출력하세요."
        ),
        "ground_truth": "42"
    }
]


def extract_answer(
    text: str
) -> str | None:
    match = re.search(
        r"<answer>\s*(.*?)\s*</answer>",
        text,
        flags=re.DOTALL
    )

    if match is None:
        return None

    return (
        match
        .group(1)
        .strip()
    )


def accuracy_reward_func(
    completions,
    ground_truth,
    **kwargs
):
    rewards = []

    for completion, answer in zip(
        completions,
        ground_truth
    ):
        predicted = extract_answer(
            completion
        )

        reward = (
            1.0
            if predicted == str(answer)
            else 0.0
        )

        rewards.append(
            reward
        )

    return rewards


def format_reward_func(
    completions,
    **kwargs
):
    pattern = re.compile(
        r".*<answer>\s*"
        r"[-+]?[0-9]+(?:\.[0-9]+)?"
        r"\s*</answer>\s*$",
        flags=re.DOTALL
    )

    rewards = []

    for completion in completions:
        valid = bool(
            pattern.fullmatch(
                completion.strip()
            )
        )

        rewards.append(
            1.0
            if valid
            else 0.0
        )

    return rewards


def main():
    dataset = Dataset.from_list(
        TRAINING_DATA
    )

    split_dataset = (
        dataset.train_test_split(
            test_size=0.2,
            seed=SEED,
            shuffle=True
        )
    )

    train_dataset = (
        split_dataset["train"]
    )

    eval_dataset = (
        split_dataset["test"]
    )

    lora_config = LoraConfig(
        task_type=(
            TaskType.CAUSAL_LM
        ),

        r=16,

        lora_alpha=32,

        lora_dropout=0.05,

        target_modules=[
            "q_proj",
            "k_proj",
            "v_proj",
            "o_proj"
        ],

        bias="none"
    )

    training_args = GRPOConfig(
        output_dir=str(
            OUTPUT_DIR
        ),

        learning_rate=5e-6,

        lr_scheduler_type=(
            "linear"
        ),

        warmup_ratio=0.1,

        per_device_train_batch_size=1,

        per_device_eval_batch_size=1,

        gradient_accumulation_steps=4,

        num_train_epochs=3,

        num_generations=4,

        num_generations_eval=2,

        max_completion_length=128,

        temperature=0.8,

        top_p=0.95,

        beta=0.0,

        num_iterations=1,

        epsilon=0.2,

        scale_rewards="group",

        loss_type="dapo",

        reward_weights=[
            1.0,
            0.2
        ],

        eval_strategy="epoch",

        save_strategy="epoch",

        logging_strategy="steps",

        logging_steps=1,

        logging_first_step=True,

        save_total_limit=2,

        gradient_checkpointing=True,

        log_completions=True,

        num_completions_to_print=2,

        report_to="none",

        seed=SEED,

        data_seed=SEED,

        run_name=(
            "math-grpo-lora"
        )
    )

    trainer = GRPOTrainer(
        model=MODEL_ID,

        args=training_args,

        reward_funcs=[
            accuracy_reward_func,
            format_reward_func
        ],

        train_dataset=train_dataset,

        eval_dataset=eval_dataset,

        peft_config=lora_config
    )

    print(
        "[GRPO 학습 시작]"
    )

    trainer.train()

    print(
        "[최종 모델 저장]"
    )

    trainer.save_model(
        str(
            OUTPUT_DIR
        )
    )

    print(
        f"저장 위치: "
        f"{OUTPUT_DIR.resolve()}"
    )


if __name__ == "__main__":
    main()
이 프로젝트는 Custom Reward Function 두 개를 사용합니다.
accuracy_reward_func

→ 최종 정답 평가


format_reward_func

→ <answer> 형식 평가
GRPOTrainer는 여러 Reward Function의 반환값을 `reward_weights`에 따라 조합할 수 있습니다.
58. 학습 결과 저장과 추론
저장:
trainer.save_model(
    "models/math-grpo"
)
현재 `GRPOTrainer.save_model()`은 학습 Model을 `from_pretrained()`로 다시 불러올 수 있는 형태로 저장합니다.
LoRA를 사용했다면 PEFT Adapter 중심의 저장 구조를 확인합니다.
추론 예:
import torch

from peft import (
    AutoPeftModelForCausalLM
)

from transformers import (
    AutoTokenizer
)


MODEL_PATH = (
    "outputs/"
    "math-grpo"
)


tokenizer = (
    AutoTokenizer
    .from_pretrained(
        MODEL_PATH
    )
)


model = (
    AutoPeftModelForCausalLM
    .from_pretrained(
        MODEL_PATH
    )
)


if torch.cuda.is_available():
    device = torch.device(
        "cuda"
    )

elif torch.backends.mps.is_available():
    device = torch.device(
        "mps"
    )

else:
    device = torch.device(
        "cpu"
    )


model = model.to(
    device
)

model.eval()
Prompt:
prompt = (
    "문제: 23 × 7의 값을 계산하세요. "
    "최종 답은 반드시 "
    "<answer>숫자</answer> "
    "형식으로 출력하세요."
)
Tokenization:
inputs = tokenizer(
    prompt,
    return_tensors="pt"
).to(
    device
)
생성:
with torch.inference_mode():
    outputs = model.generate(
        **inputs,

        max_new_tokens=128,

        do_sample=False,

        eos_token_id=(
            tokenizer.eos_token_id
        ),

        pad_token_id=(
            tokenizer.pad_token_id
        )
    )
출력:
response = tokenizer.decode(
    outputs[0],
    skip_special_tokens=True
)


print(
    response
)
59. GRPO 학습 전후 평가
학습 전 모델과 GRPO 모델을 같은 문제로 평가합니다.
Test Prompt:

23 × 7

37 + 58

512 ÷ 16

(12 + 8) × 6

15 × 9 - 20
다음 지표를 기록합니다.
| 항목 | Base | GRPO |
|---|---|---|
| 정답률 | 측정 | 측정 |
| Format 준수율 | 측정 | 측정 |
| 평균 Completion 길이 | 측정 | 측정 |
| EOS 비율 | 측정 | 측정 |
| 평균 Reward | 측정 | 측정 |
GRPO Training Reward만 상승했다고 성공으로 판단하지 않습니다.
독립 Test Set에서 실제 Accuracy를 확인합니다.
60. Reward Hacking
GRPO에서도 Reward Hacking은 매우 중요합니다.
예를 들어 Reward Function을 잘못 만들었다고 하겠습니다.
def bad_reward(
    completions,
    **kwargs
):
    return [
        1.0
        if "<answer>" in text
        else 0.0

        for text in completions
    ]
모델이 발견합니다.
<answer>0</answer>Reward:
1또 생성:
<answer>바나나</answer>Reward:
1모델:
“정답은 중요하지 않군요.

태그만 쓰면 됩니다.”
이것은 모델이 멍청한 것이 아닙니다.
Reward Function을 정확하게 최적화한 것입니다.
잘못된 Reward

+

강력한 강화학습

=

잘못된 행동을
매우 잘하는 모델
따라서 Reward 설계가 핵심입니다.
61. 자주 발생하는 오류
오류 1. GRPOTrainer Import 실패
현재 방식:
from trl import (
    GRPOConfig,
    GRPOTrainer
)
GRPOTrainer는 현재 TRL의 일반 Trainer API입니다.
업데이트:
python -m pip install --upgrade trl오류 2. 오래된 TRL 버전
확인:
python -m pip show trl2026년 8월 14일 기준 최신 PyPI 버전은 1.10.0입니다.
오류 3. num_generations와 Batch가 맞지 않음
예:
per_device_train_batch_size=1
gradient_accumulation_steps=4
num_generations=3
1 GPU에서는 Effective Batch 4가 3으로 나누어 떨어지지 않습니다.
현재 GRPOTrainer는 Effective Batch Size가 `num_generations`로 나누어 떨어져야 합니다.
해결:
num_generations=4오류 4. Reward Function Argument 오류
잘못된 함수:
def reward_func(
    answers
):
    ...
권장:
def reward_func(
    completions,
    **kwargs
):
    ...
필요하면:
def reward_func(
    completions,
    ground_truth,
    **kwargs
):
    ...
현재 Reward Function은 Prompt, Completion과 추가 Dataset 열을 Keyword Argument로 전달받을 수 있습니다.
오류 5. ground_truth를 받을 수 없음
`ground_truth` 열이 Dataset에 있는지 확인합니다.
print(
    dataset.column_names
)
그리고:
remove_unused_columns=False를 유지합니다.
현재 GRPOConfig 기본값은 이미 `False`입니다.
오류 6. Reward가 항상 0
먼저 생성 결과를 직접 확인합니다.
log_completions=True현재 이 설정을 활성화하면 Logging Step마다 Prompt와 Completion Sample을 기록하거나 출력할 수 있습니다.
확인:
정답 추출 Regex 오류

Format 불일치

ground_truth 타입 불일치

모델이 Tag를 생성하지 않음
오류 7. frac_reward_zero_std가 계속 1
모든 답변이 같은 Reward라는 의미입니다.
해결 후보:
Temperature 증가

문제 난이도 조정

Reward를 더 세밀하게 설계

num_generations 증가

Binary Reward 외 Partial Reward 추가
오류 8. 모델이 같은 답변만 생성
Temperature가 너무 낮을 수 있습니다.
temperature=1.0현재 기본값도 1.0입니다.
다음도 조정할 수 있습니다.
top_p=0.95오류 9. CUDA Out of Memory
GRPO는 하나의 Prompt에서 여러 Completion을 생성하기 때문에 `num_generations`와 `max_completion_length`가 메모리에 큰 영향을 줄 수 있습니다.
우선:
per_device_train_batch_size 감소

num_generations 감소

max_completion_length 감소

LoRA 사용

QLoRA 사용

Gradient Checkpointing
을 검토합니다.
현재 GRPOConfig는 Gradient Checkpointing을 기본 활성화하고 있으며 QLoRA용 `quantization_config`와 PEFT를 지원합니다.
오류 10. beta를 켰더니 메모리 증가
beta=0.001처럼 0보다 크게 설정하면 Reference Model이 필요합니다.
현재 기본 `beta=0.0`에서는 Reference Model을 로드하지 않아 메모리와 시간을 절약합니다.
오류 11. Reward는 상승하지만 정답률은 그대로
Format Reward만 학습하고 있을 수 있습니다.
예:
Accuracy Reward:

0


Format Reward:

1
모델:
“정답은 모르지만
태그는 정말 예쁘게 쓰겠습니다.”
각 Reward Function의 개별 Metric을 확인합니다.
rewards/accuracy_reward_func/mean

rewards/format_reward_func/mean
TRL은 Reward Function별 평균과 표준편차를 별도 기록합니다.
오류 12. Completion이 계속 최대 길이까지 생성됨
확인:
completions/clipped_ratio이 높다면 Generation이 `max_completion_length`에 자주 도달하고 있을 수 있습니다.
Prompt에서 원하는 종료 형식을 명확하게 지정하거나 Generation Length와 Reward를 검토합니다.
오류 13. loss_type="grpo"가 기본인 줄 알았음
2026년 현재 기본값은:
loss_type="dapo"입니다.
Original GRPO:
loss_type="grpo"를 명시해야 합니다.
오류 14. GRPO Loss에서 길이 Bias가 나타남
현재 공식 문서는 Original `"grpo"` Loss를 Length Bias 때문에 권장하지 않으며 다음 옵션을 제공합니다.
loss_type="dapo"또는:
loss_type="dr_grpo"오류 15. Reward Scaling이 이상함
비교:
scale_rewards="group"scale_rewards="batch"scale_rewards=False현재 세 방식 모두 지원됩니다.
오류 16. vLLM 사용 시 메모리 부족
Colocate Mode에서는 Training Model과 vLLM이 같은 GPU 자원을 공유합니다.
현재 TRL은:
vllm_gpu_memory_utilization=0.3을 기본값으로 사용합니다.
필요하면 낮춥니다.
vllm_gpu_memory_utilization=0.2또는 Server Mode로 Generation GPU를 분리합니다.
오류 17. vLLM을 설치했는데 동작하지 않음
TRL의 vLLM 통합을 사용하려면 호환 가능한 vLLM 버전과 GPU 구성이 필요합니다. 현재 공식 vLLM Integration 문서는 TRL이 지원하는 vLLM 범위를 별도로 안내하고 있으므로 설치 시 해당 버전 호환성을 확인해야 합니다.
권장 설치:
python -m pip install "trl[vllm]"오류 18. Reward Function이 너무 느림
Reward Function에서 매번:
외부 API

데이터베이스

대형 모델
을 호출하면 Generation보다 Reward 계산이 병목이 될 수 있습니다.
현재 Custom Reward Function은 `async def`도 지원하며 여러 Async Reward Function은 동시에 Await될 수 있습니다.
오류 19. Eval에서 Generation 비용이 너무 큼
현재 별도로:
num_generations_eval=2를 지정할 수 있습니다.
설정하지 않으면 Training의 `num_generations` 값을 사용합니다.
오류 20. 모델이 Reward Function의 허점을 발견함
이것은 Bug가 아니라 강화학습의 전형적인 실패 패턴일 수 있습니다.
다음 검증을 수행합니다.
Reward와 실제 Accuracy 비교

Reward와 답변 길이 비교

Reward와 Format 비교

Random Sample 사람 검수

Held-out Test

Adversarial Prompt Test
Reward가 올라가는데 사람 평가가 떨어지면 Reward 설계부터 다시 확인합니다.
62. PPO·DPO·GRPO 비교
지금까지 세 방법을 한 번에 정리해 보겠습니다.
| 항목 | DPO | PPO | GRPO |
|---|---|---|---|
| 학습 형태 | Offline | Online | Online |
| Prompt만으로 학습 가능 | 아니오 | 예 | 예 |
| Chosen·Rejected 필요 | 예 | 아니오 | 아니오 |
| 학습 중 답변 생성 | 필수 아님 | 예 | 예 |
| Reward Model | 불필요 | 보통 필요 | 선택적 |
| Rule Reward | 직접 구조 아님 | 가능 | 매우 적합 |
| Value Model | 없음 | 있음 | 없음 |
| Group Sampling | 없음 | 기본 아님 | 핵심 |
| Advantage | Preference Loss | Value 기반 | Group Reward 기반 |
| 구현 복잡도 | 비교적 낮음 | 높음 | 중간 |
| Memory 부담 | 비교적 낮음 | 높음 | PPO보다 낮을 수 있음 |
| 추론형 AI 학습 | 가능 | 가능 | 대표적 활용 |
GRPO가 PPO보다 메모리 효율적이라는 핵심 이유는 Critic, 즉 Value Model을 제거하고 그룹 Reward를 이용해 Baseline을 추정하기 때문입니다.
한 문장씩 정리하면:
DPO:

“이미 비교해 둔 좋은 답과
나쁜 답을 공부하세요.”


PPO:

“직접 답하고
심판 점수와 Value Model을 보며
행동을 수정하세요.”


GRPO:

“직접 여러 번 답하고
같은 문제를 푼 답변들끼리
성적을 비교하세요.”
63. 연습 문제
문제 1
PPO와 GRPO의 가장 큰 구조적 차이를 설명하세요.
문제 2
GRPO에서 Value Model이 없어도 되는 이유를 설명하세요.
문제 3
다음 Reward의 평균을 계산하세요.
1

0

1

0
문제 4
다음 그룹에서 평균보다 Reward가 높은 Completion을 찾으세요.
A:
0.9

B:
0.4

C:
0.2

D:
0.5
문제 5
Reward가 다음과 같을 때 GRPO 학습 신호의 문제점을 설명하세요.
1

1

1

1
문제 6
`frac_reward_zero_std`가 0.9일 때 어떤 문제를 의심해야 할까요?
문제 7
`num_generations=8`을 설정하고 GPU 1개를 사용한다면 Effective Batch Size가 8의 배수가 되도록 Batch 설정을 구성하세요.
문제 8
다음 두 Reward Function을 만드세요.
정답 정확:

1점


JSON Parsing 성공:

0.2점
문제 9
Reward Weight를 다음과 같이 지정하세요.
Accuracy:

1.0


Format:

0.1
문제 10
`scale_rewards`의 다음 세 방식을 비교하세요.
group

batch

none
문제 11
다음 Loss를 각각 실험하세요.
grpo

dapo

dr_grpo
문제 12
각 Loss에서 다음 값을 비교하세요.
Accuracy

Reward

Completion Length

Training Stability
문제 13
LoRA Rank를 다음처럼 변경하세요.
8

16

32
문제 14
Temperature를 비교하세요.
0.3

0.8

1.2
그리고:
Reward Std

Zero Std 비율
을 비교하세요.
문제 15
`num_generations`를 비교하세요.
2

4

8
문제 16
다음 Metric을 CSV로 저장하세요.
reward

reward_std

frac_reward_zero_std

completions/mean_length

kl
문제 17
Reward Function에 다음 추가 Dataset 열을 사용하세요.
difficulty

category

ground_truth
문제 18
정답 Reward와 Format Reward가 충돌하는 예제를 만들어 보세요.
문제 19
vLLM Colocate Mode와 Server Mode의 장단점을 비교하세요.
문제 20
다음 실전 프로젝트를 확장하세요.
산술 문제 1,000개 생성

Train·Validation·Test 분리

Accuracy Reward

Format Reward

답변 길이 Reward

LoRA GRPO 학습

학습 전후 Accuracy 비교

Reward Curve 저장

Zero Std 분석

오답 Sample CSV 저장

Gradio 테스트 화면
64. 핵심 요약
GRPO Import
from trl import (
    GRPOConfig,
    GRPOTrainer
)
Dataset
dataset = Dataset.from_list([
    {
        "prompt": (
            "12 × 7은? "
            "<answer>숫자</answer>"
        ),

        "ground_truth": "84"
    }
])
Accuracy Reward
def accuracy_reward_func(
    completions,
    ground_truth,
    **kwargs
):
    rewards = []

    for completion, answer in zip(
        completions,
        ground_truth
    ):
        predicted = extract_answer(
            completion
        )

        rewards.append(
            1.0
            if predicted == answer
            else 0.0
        )

    return rewards
LoRA
lora_config = LoraConfig(
    task_type=(
        TaskType.CAUSAL_LM
    ),

    r=16,

    lora_alpha=32,

    target_modules=[
        "q_proj",
        "k_proj",
        "v_proj",
        "o_proj"
    ]
)
GRPOConfig
training_args = GRPOConfig(
    output_dir="outputs/grpo",

    learning_rate=5e-6,

    per_device_train_batch_size=1,

    gradient_accumulation_steps=4,

    num_generations=4,

    max_completion_length=128,

    temperature=0.8,

    beta=0.0,

    epsilon=0.2,

    scale_rewards="group",

    loss_type="dapo",

    reward_weights=[
        1.0,
        0.2
    ],

    log_completions=True,

    report_to="none"
)
GRPOTrainer
trainer = GRPOTrainer(
    model=MODEL_ID,

    args=training_args,

    reward_funcs=[
        accuracy_reward_func,
        format_reward_func
    ],

    train_dataset=train_dataset,

    peft_config=lora_config
)
학습
trainer.train()저장
trainer.save_model(
    "models/grpo-model"
)
65. 마무리
이번 시간에는 PPO에서 사용했던 Value Model을 제거하고, 같은 Prompt에서 생성된 여러 답변의 Reward를 상대 비교하는 GRPO를 알아보았습니다.
전체 흐름을 다시 정리해 보겠습니다.
Prompt

↓

Policy가 여러 답변 생성

├─ A
├─ B
├─ C
└─ D

↓

각 답변 Reward 계산

↓

Group 평균 계산

↓

Group 내 상대 Advantage 계산

↓

좋은 답변 강화

나쁜 답변 억제

↓

Policy 업데이트
PPO에서는 다음 질문이 필요했습니다.
Value Model:

“이 상태에서 앞으로
얼마나 좋은 Reward를
받을 것으로 예상합니까?”
GRPO에서는 질문이 달라집니다.
GRPO:

“같은 문제를 푼 친구들보다
잘했습니까?”
이 차이가 굉장히 큽니다.
PPO:

절대적인 예상 가치가 필요


GRPO:

그룹 안에서의
상대적인 성적이 필요
Value Model이 사라지면서 PPO보다 학습 구조와 메모리 요구량을 줄일 수 있습니다. 이것이 DeepSeekMath에서 GRPO를 제안한 주요 동기 중 하나였습니다.
GRPO가 추론형 AI 학습과 잘 연결되는 이유도 명확합니다.
수학 문제

→ 답이 맞았는가?


코딩 문제

→ Test를 통과했는가?


SQL 문제

→ 실행 결과가 맞는가?


퍼즐

→ 규칙을 만족했는가?
결과를 자동으로 검증할 수 있다면:
사람이 매번 채점

또는

별도의 Reward Model
없이 Rule-based Reward를 사용할 수 있습니다.
그리고 하나의 Prompt에서 여러 Candidate를 생성하면:
누가 잘했는지

누가 못했는지
를 그룹 안에서 자동으로 비교할 수 있습니다.
하지만 GRPO에도 함정이 있습니다.
가장 대표적인 것이:
Reward:

0
0
0
0
또는:
Reward:

1
1
1
1
인 상황입니다.
모든 친구가 똑같은 점수를 받았습니다.
GRPO:

“우수 학생을 선발하겠습니다.”


성적표:

100점
100점
100점
100점


GRPO:

“...전원 우수 학생?”
이 경우 Relative Advantage를 만들 정보가 부족합니다.
그래서:
reward_std

frac_reward_zero_std
같은 Metric이 매우 중요합니다.
또한 Reward Function 설계는 여전히 핵심입니다.
좋은 Reward

→ 좋은 행동 강화


엉성한 Reward

→ Reward의 허점을 잘 이용하는 모델
AI는 우리가 의도한 목표를 읽지 않습니다.
우리가 실제로 계산한 Reward를 최적화합니다.
개발자:

“정확하고 간결한 답을 하라는 뜻이었는데요.”


Reward Function:

“저는 <answer> 태그가 있으면
점수를 줬을 뿐입니다.”


AI:

“그래서 태그를 아주 잘 쓰게 되었습니다.”
강화학습에서는 코드 한 줄이 곧 교육 철학이 됩니다.
그리고 최신 TRL을 사용할 때 한 가지 더 기억해야 합니다.
GRPOTrainer

≠

항상 Original GRPO Loss
2026년 현재 기본 Loss는:
loss_type="dapo"입니다. Original GRPO의 Length Bias와 이후 연구 결과를 반영해 Trainer 안에서 여러 GRPO 계열 Objective를 선택할 수 있도록 발전했습니다.
즉 오늘 배운 `GRPOTrainer`는 이제 단순한 단일 알고리즘 구현이라기보다:
GRPO

DAPO

Dr. GRPO

SAPO

여러 Reward

LoRA·QLoRA

vLLM

Tool·Environment Training
까지 연결되는 Online Reinforcement Learning 훈련 플랫폼에 가까워지고 있습니다. 현재 GRPOTrainer는 Custom Reward, Reward Model, PEFT, Quantization, vLLM, Tool과 Stateful Environment까지 지원합니다.
PPO에서:
Policy

Reference

Reward

Value
네 명이 회의실에 모였다면,
GRPO에서는:
Policy:

“답변 여러 개 뽑았습니다.”


Reward:

“점수 매겼습니다.”


GRPO:

“그럼 서로 비교합시다.”
훨씬 단순한 회의가 열립니다.
추론형 AI 강화학습의 중요한 퍼즐 하나를 완성했습니다. 🧠🏆
다음 편 예고
[Python 완전정복 시리즈 #44] RLOOTrainer 완벽 이해하기 | 나 자신을 제외한 평균 Reward로 AI를 강화학습하는 방법
다음 시간에는 또 다른 Value Model 없는 Online RL 방법, RLOO를 알아봅니다.
RLOO의 핵심 아이디어는 재미있습니다.
4개의 답변이 있다고 하겠습니다.
A
B
C
D
A의 Baseline을 계산할 때:
A는 빼고

B
C
D

평균 계산
B의 Baseline:
B는 빼고

A
C
D

평균 계산
즉:
Leave One Out입니다.
학생 A:

“제 점수도 반 평균에 넣나요?”


RLOO:

“아니요.

본인 빼고 친구들 평균만 보겠습니다.”
GRPO의 Group Relative Advantage와 어떤 차이가 있는지, 왜 Leave-One-Out Baseline이 Variance를 줄이는 데 도움이 되는지, TRL의 `RLOOTrainer`와 LoRA를 이용해 직접 구현해 보겠습니다.
#Python #파이썬 #Python강좌 #HuggingFace #TRL #GRPO #GRPOTrainer #GroupRelativePolicyOptimization #강화학습 #ReinforcementLearning #RLHF #ReasoningModel #추론형AI #DeepSeekMath #DeepSeekR1 #RewardFunction #AccuracyReward #FormatReward #Advantage #GroupReward #DAPO #DrGRPO #RewardScaling #LoRA #QLoRA #PEFT #vLLM #Transformers #LLM #생성형AI #AI정렬 #PostTraining #OnlineRL #PyTorch #코딩공부 #프로그래밍